 Langschwanz
Kostenlos
Langtail ist eine Prompt-Management- und LLMOps-Plattform für KI-Produktteams. Es nutzt Playgrounds, Tests, Bereitstellungen, Protokolle und Metriken, um Eingabeaufforderungen vom Experiment bis zur Produktion voranzutreiben.
Langtail-Werkzeugtext
Kernparameter und Statistiken
| Parameter | Aktuelle öffentliche Informationen | Beschreibung |
|---|---|---|
| Offizielle Positionierung | Promptes Management für Produktteams / LLMOps-Plattform | Auf der Homepage der offiziellen Website wird „KI-Eingabeaufforderungen gemeinsam erstellen, testen und bereitstellen“ betont, und im [offiziellen Dokument] (https://langtail.com/docs/introduction/what-is-langtail) wird es weiter als eine LLMOps-Plattform definiert, die sich am Lebenszyklus von KI-Anwendungen orientiert. |
| Kernobjekte | Arbeitsbereich, Projekt, Eingabeaufforderung, Eingabeaufforderungsversion, Bereitstellung, Protokoll, Metrik, Test | Das Konzeptsystem deckt alles vom Prompt-Schreiben bis zur Produktionsüberwachung ab und ist kein einzelner Prompt-Editor. |
| Haupteingang | Webkonsole, Bereitstellungs-API, OpenAI-Proxy, SDK | Dokumentindex listet die Schnittstellen für Bereitstellungs-API, Proxy, SDK, Assistenten und Threads auf. |
| Zielbenutzer | Produktteams, Ingenieurteams QA/KI-Testteams | Sowohl der offizielle Titel als auch der Langtail 1.0-Blog betrachten „Produktteams, die KI-Anwendungen testen“ als Kerngruppe. |
| Öffentliches Bereitstellungsformular | Cloud-SaaS; Enterprise unterstützt Selbsthosting | Preisseite listet Self-Hosting in der Enterprise-Datei auf. |
| Kostenloses Kontingent | Kostenlos, 0 $/Monat + MwSt. | Beinhaltet unbegrenzte Benutzer, 2 Eingabeaufforderungen oder Assistenten, 1.000 Protokolle/Monat, 30 Tage Datenaufbewahrung. |
Langtail ähnelt eher einem „Stichwort-Produktionssystem“ als einer „Stichwort-Inspirationsbibliothek“. Es bringt Eingabeaufforderungsvorlagen, Variablen, Toolaufrufe, Modellparameter, Testaussagen, Bereitstellungskontext und Online-Protokolle in derselben Workbench zusammen. Es eignet sich für Teams, die LLM-Funktionen in Produkte eingebettet haben und Regressionsrisiken und Online-Kommunikationskosten reduzieren müssen.
Benutzer- und Markterkennung
- Öffentliche Kundensignale: Sowohl die offizielle Website als auch der öffentliche Beta-Blog zitierten das Fall-Feedback von Deepnote. Deepnote-Ingenieur Ondřej Romancov kommentierte, dass Langtail die Entwicklung und das Testen von Deepnote AI vereinfacht habe. Solche Signale deuten darauf hin, dass sich die ersten Anwender von Langtail auf B2B-Softwareteams konzentrieren, die bereits über KI-Produktfähigkeiten verfügen.
- Zeitplan für die Produktveröffentlichung: Auf der offiziellen About-Seite wird die erste Beta-Veröffentlichung im Oktober 2023 verzeichnet, die Finanzierung erfolgte im Januar 2024 und der Start von Product Hunt im April 2024; Dies ergibt einen minimalen Marktvalidierungspfad vom internen Test bis zur öffentlichen Beta.
- Öffentliches Listensignal: Die mit der Produktsuche verbundenen öffentlichen Seitendatensätze Langtail Public Beta wurden am 25. April 2024 in die Tagesliste aufgenommen; Diese Art des Rankings eignet sich nur als Signal für die Beliebtheit bei der Markteinführung und ist nicht gleichbedeutend mit langfristigen Kundenbindungs- oder Umsatzdaten.
- Unbekannte Grenze: Auf der offiziellen Website werden die Anzahl der aktiven Kunden (ARR), die Kundenbindungsrate, die Liste der verfügbaren Regionen oder die Anzahl der Unternehmensverträge nicht offengelegt, sodass diese Dimensionen nicht zur Bestimmung des Umfangs herangezogen werden können. Eine wertvollere Beurteilung auf der Beschaffungsseite besteht darin, zunächst zu prüfen, ob die vorhandenen KI-Funktionen in Produktion gegangen sind und ob das Team wirklich Tests und Bereitstellungsmanagement benötigt.
Kostenvorteil
- C-Kunde/Einzelperson: Die kostenlose Datei kann verwendet werden, um kleine Projekte mit 0 $/Monat + MwSt. zu starten, was für die Überprüfung von 1-2 Eingabeaufforderungen oder Assistenten geeignet ist; Die kostenlose Stufe umfasst jedoch nur 1.000 Protokolle/Monat und eine Aufbewahrungsfrist von 30 Tagen, was für eine ernsthafte Produktionsüberwachung nicht geeignet ist.
- Entwickler/API: Das Pro-Profil ist öffentlich verfügbar für 99 $/Monat + MwSt., 1 Benutzer, 20 Eingabeaufforderungen oder Assistenten, unbegrenzte Protokolle, 90 Tage Aufbewahrung. Der Kostenvorteil besteht nicht darin, dass „Modellaufrufe günstiger sind“, sondern darin, dass die Entwicklungszeit für das manuelle Einfügen von Testbeispielen und das wiederholte Ändern des Codes zum Bereitstellen von Eingabeaufforderungen verkürzt wird.
- Unternehmen/Privat: Das Teamprofil ist für 499 $/Monat + MwSt. öffentlich zugänglich, 10 Benutzer, unbegrenzte Eingabeaufforderungen oder Assistenten, 1 Jahr Aufbewahrung, Radare und Warnungen sowie dedizierter Support; Enterprise ist individuell, einschließlich AI Firewall, Selbsthosting und benutzerdefinierter Aufbewahrung. Die Unternehmenskosten müssen zusammen mit Abonnementgebühren, Abrechnung durch Modellanbieter, Protokollaufbewahrung, Compliance-Überprüfungen und Integrationsaufwand bewertet werden.
| Planebene | Offizieller öffentlicher Preis | Wichtige Einschränkungen/Fähigkeiten | Geeignete Bühne |
|---|---|---|---|
| Kostenlos | 0 $/Monat + MwSt. | Unbegrenzte Benutzeranzahl; 2 Ansagen oder Assistenten; 1.000 Protokolle/Monat; 30 Tage Aufbewahrung | Persönliche Verifizierung, kleiner PoC |
| Pro | 99 $/Monat + MwSt. | 1 Benutzer; 20 Eingabeaufforderungen oder Assistenten; unbegrenzte Protokolle; 90 Tage Aufbewahrung | Unabhängiger Entwickler oder alleiniger KI-Produktleiter |
| Team | 499 $/Monat + MwSt. | 10 Benutzer; unbegrenzte Eingabeaufforderungen; 1 Jahr Aufbewahrung; Radare und Warnungen; engagierte Unterstützung | Mehrpersonen-Produkt-/Engineering-/QS-Zusammenarbeit |
| Unternehmen | Benutzerdefiniert | Unbegrenzte Benutzeranzahl; kundenspezifische Aufbewahrung; KI-Firewall; engagierte Unterstützung; Selbsthosting | Große Organisationen, Compliance oder private Bereitstellungen |
Hauptfunktionen
- Gemeinsames Schreiben im Playground: Playground unterstützt Vorlagen, Variablen, Tools, Modellparameter, Versionen, Freigabe- und Bereitstellungsportale. Die Bedeutung des Produkts besteht darin, dass Produkt-, Technik- und Eingabeaufforderungsleiter die Ausgabe auf derselben Schnittstelle besprechen können, anstatt Eingabeaufforderungen in Code, Dokumenten und Chat-Protokollen zu verstreuen.
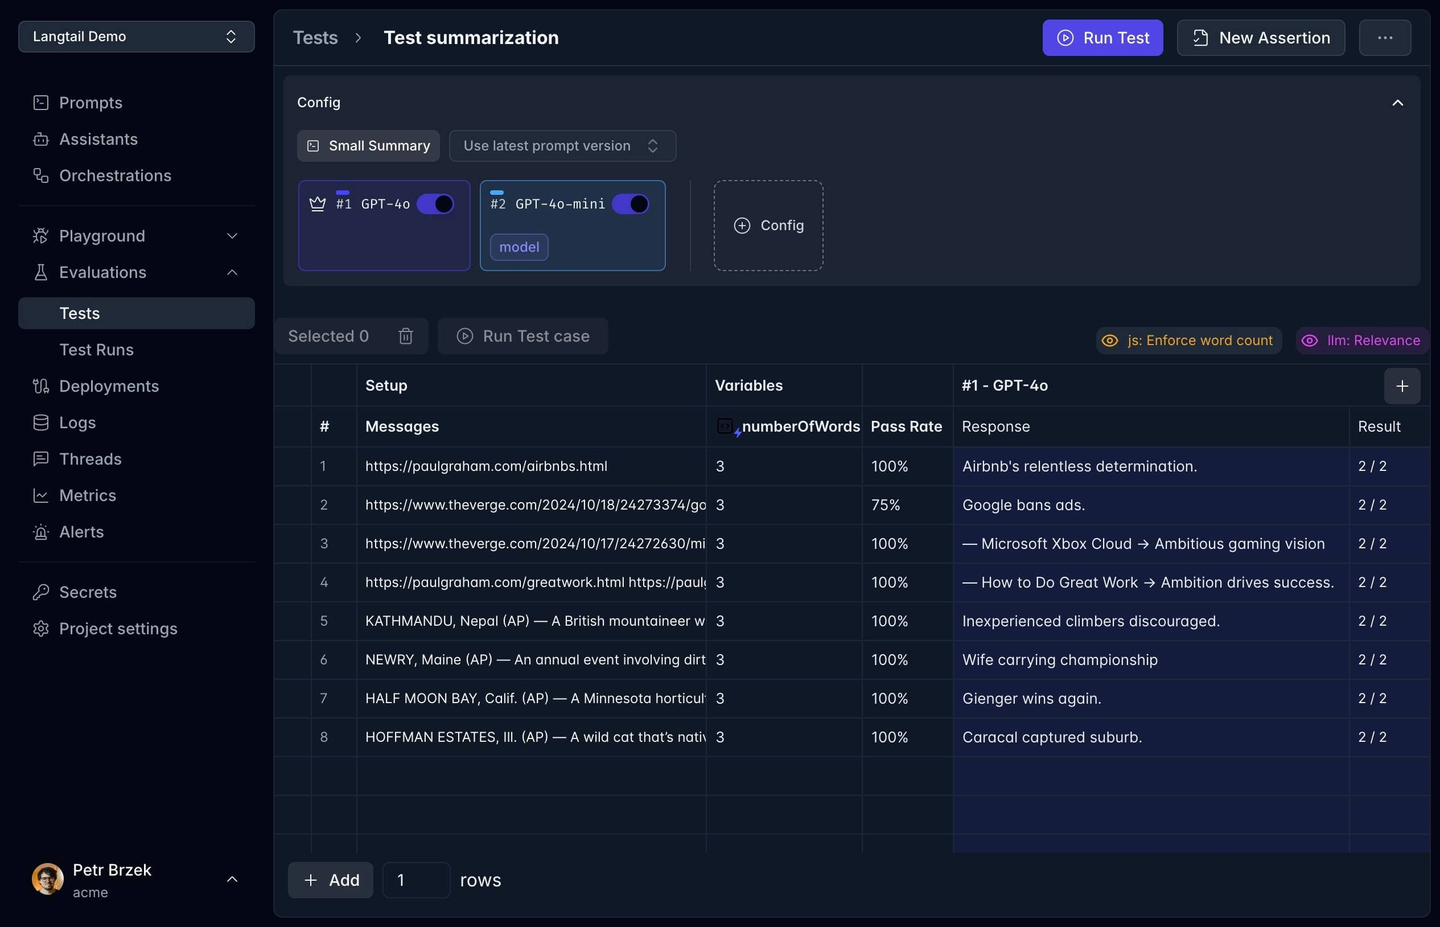
- Tests und Behauptungen: Tests bestehen aus Fällen und Behauptungen, und die Behauptungstypen umfassen Text-Assertionen, JavaScript-Assertionen und LLM-Assertionen. Textzusicherungen eignen sich für deterministische Formate, JavaScript eignet sich für strukturierte Regeln und LLM-Zusicherungen eignen sich für Standards natürlicher Sprache und Klassifizierungsbewertung.
- Bereitstellungs-API: Bereitstellungen können Prompt als API-Endpunkt veröffentlichen und Kontext, Version und Rollback unterstützen. Dadurch wird die Häufigkeit des „Neuveröffentlichens der Anwendung beim Ändern der Eingabeaufforderung“ verringert, jedoch nur, wenn das Team bereit ist, den Lebenszyklus der Eingabeaufforderung an das Plattform-Hosting zu übergeben.
- Protokolle und Metriken: Jeder Bereitstellungsaufruf oder jede OpenAI-Proxy-Anfrage generiert ein Protokoll. Mithilfe von Metriken können Aktivitäten, Verzögerungen und Kosten aus den Prompt- oder Projektdimensionen angezeigt werden. Bei Produktions-KI-Anwendungen entspricht dies eher einer geschäftlichen Fehlerbehebungsperspektive als der bloßen Betrachtung von Musterrechnungen von Anbietern.
- Assistenten und Threads: Der Dokumentindex listet Assistenten, Threads und Thread-Nachrichten-API auf, was darauf hinweist, dass Langtail nicht nur eine einzelne Eingabeaufforderung verwaltet, sondern auch Konversationsanwendungen mit längeren Kontexten abdeckt.
- KI-Firewall und Warnungen: Auf der offiziellen Website und Preisseite werden KI-Firewall, Radare und Warnungen angezeigt, die für Sicherheitsausgaben, abnormales Verhalten und betriebliches Alarmmanagement von Teams mit höherem Risiko verwendet werden.
Modell- und Versionsentwicklung
| Zeit | Version/Meilenstein | Offizielle öffentliche Änderungen | Produktbedeutung |
|---|---|---|---|
| 2023-10 | Erste Testversion | Die About-Seite dokumentiert die Veröffentlichung der ersten Testversion beim Prager KI-Treffen | Der Ausgangspunkt des Produkts sind Probleme beim Debuggen und Evaluieren von KI-Anwendungen und nicht das allgemeine Modelltraining. |
| 25.04.2024 | Öffentliche Beta | Offizieller Blog Arbeitsbereich für öffentliche Zusammenarbeit Spielplatz, sofortige Bereitstellung, Protokollanalyse, Testen von OpenAI und Azure OpenAI-Unterstützung | Langtail tritt nach internen Tests in die Phase der öffentlichen Verfügbarkeit ein. |
| 29.10.2024 | Langtail 1.0 | Offizieller Blog veröffentlicht tabellenähnliche Testoberfläche, Testkonfigurationen, gehostete Code-Tools und Assistenten | Der Produktschwerpunkt hat sich offensichtlich auf KI-Anwendungstests und QA-Workflows verlagert. |
| 14.02.2025 | Testverbesserungen und Infrastrukturaktualisierungen | Aktualisierte Anzeige der Erfolgsquote der Protokollierungstestkonfiguration, Tool-Aufruf-Fokus-Reparatur-O1-Serie-Argumentation, Aufwandsverarbeitung usw. | Der Schwerpunkt der Iterationen liegt auf Testerfahrung, Modellkompatibilität und betrieblicher Detailstabilität. |
Langtails „Version“ ist keine Installationspaketnummer für herkömmliche Desktop-Software, sondern ein funktionaler Meilenstein für die Cloud-Plattform. Für Anwender ist es wichtiger, darauf zu achten, welche Modellanbieter, Assertionstypen, Protokolldimensionen und Bereitstellungsmodi unterstützt werden, da sich diese Funktionen direkt auf Regressionstests und Fehlerortung auswirken, nachdem die KI-Funktion online geht.
Technische Vorteile
- Mechanismus: Prompt-Version und Bereitstellungskontext entkoppeln Anwendungscode. Der Effekt besteht darin, dass Prompt-Anpassungen über die Bereitstellungsversion von Langtail übertragen werden können, anstatt jedes Mal die Veröffentlichung des Anwendungscodes auszulösen; Anwendbare Szenarien sind Produktfunktionen mit häufigen Prompt-Iterationen wie Kundendienstroboter, Inhaltsgenerierung, Such-Fragen und Antworten usw.
- Mechanismus: Tabellierung von Testfällen + mehrere Assertionstypen. Der Effekt besteht darin, dass Produktqualitätssicherung und -technik die Ausgabe anhand derselben Charge von Fällen überprüfen können, anstatt jeweils mehrere Proben manuell zu testen. Anwendbare Szenarien sind KI-Funktionen, die eine kontinuierliche Regression im Ausgabeformat, im Compliance-Wortlaut, in den Klassifizierungsergebnissen und in der Qualität der Zusammenfassung erfordern.
- Mechanismen: Protokollierung von Anfragen, Lieferantenantworten, Kosten- und Latenzmetriken. Der Effekt besteht darin, dass Online-Probleme aus dem spezifischen Protokoll in den Wiederholungskontext des Spielplatzes zurückgeführt werden können. Das anwendbare Szenario ist die Fehlerbehebung, wenn in der Produktionsumgebung Ausgabeabweichungen, Kostenanomalien oder Verzögerungsschwankungen auftreten.
- Mechanismus: OpenAI-kompatibel und SDK/API-Zugang. Der Effekt besteht darin, dass Teams Langtail neben bestehenden Modellaufruflinks einführen können, anstatt die KI-Anwendungsarchitektur komplett neu zu schreiben; Das anwendbare Szenario sind Teams, die bereits OpenAI, Azure OpenAI oder kompatible Anbieter verwenden.
- Mechanismus: Selbsthosting für Unternehmen und KI-Firewall. Der Effekt ist, dass Organisationen, die sensibler auf Datenaufbewahrung, Ausgabesicherheit und Bereitstellungsgrenzen achten, mehr Verhandlungsspielraum haben; Anwendbare Szenarien sind Szenarien mit hohen Prüfungsanforderungen wie Finanzen, medizinische Versorgung und unternehmensinterne Wissensdatenbanken.
Wie man es benutzt
- Konto und Projekt: Erstellen Sie einen Arbeitsbereich/ein Projekt, nachdem Sie die Anmelde- oder App-Konsole von der offiziellen Website aufgerufen haben, und teilen Sie eine KI-Funktion in Eingabeaufforderungen, Variablen, Modellparameter und Testdaten auf.
- Promptes Schreiben: Konfigurieren Sie System-/Benutzer-/Assistentenvorlagen, Variablen und Modellparameter im Playground und fügen Sie bei Bedarf Tools hinzu, um Funktionsaufrufe oder externes API-Verhalten zu simulieren.
- Testverifizierung: Fälle in Tests hinzufügen und Text-, JavaScript- oder LLM-Behauptungen für die Ausgabe festlegen; Wenn das Modell, die Parameter oder die Eingabeaufforderungen geändert werden, verwenden Sie dieselben Fälle, um die Erfolgsquote und die Fehlerproben zu vergleichen.
- Bereitstellung und online: Veröffentlichen Sie die bestätigte Prompt-Version in Vorschau-, Staging- oder Produktionsumgebungen über Bereitstellungen und rufen Sie sie dann aus Geschäftsanwendungen mithilfe eines API-Schlüssels oder eines SDK auf.
- Online-Überwachung: Überprüfen Sie die Protokolle und Metriken, nachdem Sie online gegangen sind, und achten Sie auf das Anrufvolumen, die Verzögerung, die Kosten und die ungewöhnliche Ausgabe. Wenn Probleme auftreten, bringen Sie die spezifischen Protokolle zur Reproduktion zurück auf den Spielplatz und entscheiden Sie dann, ob Sie die Eingabeaufforderung anpassen oder die Version zurücksetzen möchten.
Voraussetzung für den Einsatz von Langtail ist, dass das Team bereits über klare KI-Anwendungsaufgaben sowie beispielhafte Eingabe- und Ausgabestandards verfügt. Wenn Sie nur vorübergehend Aufforderungswörter schreiben oder nur einmal Inhalte erstellen, scheint das Test-, Bereitstellungs- und Überwachungssystem zu schwer zu sein.
Produktpreise
Langtail arbeitet mit einer SaaS-Abonnement- und Enterprise-Commerce-Preisstruktur. Der öffentliche Preis gilt für Free, Pro und Team. Der benutzerdefinierte Preis von Enterprise unterliegt der offiziellen Echtzeitseite und der Geschäftskommunikation. Aus der öffentlichen Preisgestaltung geht nicht hervor, ob die Modellanrufgebühr von Langtail weiterverkauft wird oder vollständig vom eigenen Anbieterschlüssel des Benutzers getragen wird. Daher sollte das offizielle Budget Plattformabonnements, Modelltokenkosten, Protokollaufbewahrung und Privatisierungsimplementierung separat berücksichtigen.
| Kostendimensionen | Frei/Pro/Team sichtbare Informationen | Sichtbare Unternehmensinformationen | Budgetbedenken |
|---|---|---|---|
| Benutzerplätze | Kostenlose unbegrenzte Benutzer; Pro 1 Benutzer; Team 10 Benutzer | Unbegrenzte Benutzer | Die Aufteilung zwischen Team und Unternehmen hängt hauptsächlich von Sitzplätzen, Bindung, Support und Compliance-Anforderungen ab. |
| Eingabeaufforderung/Assistentenmenge | Kostenlos 2; Pro 20; Team unbegrenzt | Unbegrenzt | Mehrere Geschäftsbereiche oder mehrere Kontexte überschreiten das Free/Pro-Limit schneller. |
| Protokolle und Aufbewahrung | Kostenlos 1.000 Protokolle/Monat, 30 Tage; Pro unbegrenzte Protokolle, 90 Tage; Team 1 Jahr | Benutzerdefinierte Aufbewahrung | Die Produktionsüberwachung erfordert in der Regel eine längere Aufbewahrung und eine detailliertere Prüfung. |
| Erweiterte Governance | Das Team umfasst Radare und Warnungen | Enterprise umfasst AI Firewall, Selbsthosting | Sicherheit, Alarmierung und Privatisierung sind die wichtigsten Ergänzungen zum Unternehmensprofil. |
Anwendungsszenarien
- Funktioneller AI-Regressionstest: Er eignet sich, um Ausgabeverhalten wie Zusammenfassung, Klassifizierung, Fragen und Antworten zum Kundendienst und Inhaltsgenerierung in einem Testsatz zu formulieren und die Auswirkungen von Modellaktualisierungs-Eingabeaufforderungsänderungen und Parameteränderungen auf die Erfolgsquote zu beobachten.
- Prompt vom Experiment bis zur Produktionsbereitstellung: Geeignet für Teams, deren Prompt sich häufig ändert, deren Veröffentlichungsgeschwindigkeit für Geschäftsanwendungen jedoch langsam ist. Verwenden Sie Bereitstellungsendpunkte und kontextbezogene Aliase, um die Abhängigkeit von Prompt-Iterationen von der Codefreigabe zu verringern.
- Online-LLM-Kosten- und Qualitätsüberwachung: Geeignet für Teams, die Anruf-, Verzögerungs-, Kosten- und Antwortdetails anzeigen müssen, indem sie auf Eingabeaufforderung/Projekt klicken, und Protokolle verwenden, um Online-Fehlerproben an Tests zurückzugeben und Verbesserungen zu veranlassen.
- Funktionsübergreifende schnelle Zusammenarbeit: Geeignet für Produkt-, Technik- und Betriebsqualitätssicherung, um an der Ausgabe von durch Standards definierten KI-Produkten teilzunehmen und Eingabeaufforderungswörter und Akzeptanzkriterien aus dem Code-Warehouse an eine kollaborative Schnittstelle zu extrahieren.
- Ausgabe-Governance mit hohem Risiko: Geeignet für Szenarien, die empfindlich auf falsche Antworten, sofortige Injektion, nicht autorisierte Ausgabe oder unsichere Ausgabe reagieren, kombiniert mit AI Firewall, Warnungen und Testzusicherungen für eine doppelte Governance vor und nach dem Online-Gehen.
Anwendbare Personen
- AI-Produktmanager: Es ist notwendig, Benutzerszenarien, Ausgabestandards und Startrisiken in testbare Prompt-Versionen umzuwandeln, anstatt sich ausschließlich auf die Beurteilung menschlicher Erfahrung zu verlassen.
- Engineering-Team: Prompt-Management, Bereitstellung, Protokollierung und SDK/API-Aufrufe müssen in den Engineering-Prozess integriert werden, wobei vermieden werden muss, dass Geschäftsanwendungen jedes Mal neu veröffentlicht werden, wenn Prompt angepasst wird.
- Qualitätssicherungs- und Bewertungsteam: Zum Testen von KI-Anwendungen müssen tabellarische Fälle, Behauptungen, Erfolgsquoten und Fehleraufzeichnungen verwendet werden, anstatt die Ergebnisse manuell mit gewöhnlichen Tabellenkalkulationen zu verfolgen.
- RevOps/Operational AI Team: Sie müssen echte Benutzereingaben, Ausgabequalität, Kosten und Verzögerungen beobachten und Online-Beispiele an Prompt- und Testsätze zurückmelden.
Auch die Grenzen der Inkompatibilität sind klar: Teams ohne stabile KI-Funktionalität, ohne Beispieleingabe, ohne Ausgabeakzeptanzkriterien und ohne Produktionsaufrufvolumen sollten die komplette LLMOps-Plattform nicht vorzeitig einführen. Die rein persönliche schnelle Wortsammlung, das einmalige Schreiben, das Modelltraining und die Datenanmerkung sind nicht die Hauptschlachtfelder von Langtail.
Zusammenfassung und Ausblick
Der Kernwert von Langtail besteht darin, Eingabeaufforderungen von „Zeichenfolgen im Code“ auf kollaborative, testbare, bereitstellbare und überwachbare Produktressourcen zu aktualisieren. Es eignet sich für Teams, die in die Produktivierungsphase von KI-Funktionen eingetreten sind, insbesondere für Organisationen, die beginnen, Druck auf die schnelle Regression von Modellaktualisierungen, Online-Kosten, Fehlerausgabe und teamübergreifende Zusammenarbeit zu verspüren.
Derzeit gibt es drei wesentliche Einschränkungen: Erstens wurde die vollständige Liste der Kundengröße, des Umsatz-SLA, der verfügbaren Regionen und der Modelllieferanten nicht veröffentlicht; Zweitens erfordern die private KI-Firewall und die benutzerdefinierte Aufbewahrung von Unternehmen eine geschäftliche Bestätigung. Drittens hängt der Wert der Plattform von der Fähigkeit des Teams ab, qualitativ hochwertige Testsätze und klare Akzeptanzkriterien aufrechtzuerhalten. Ein umsichtigerer Ansatz bei der Implementierung besteht darin, eine Hochfrequenz-KI-Funktion für zwei bis vier Wochen als Pilotprojekt auszuwählen, die Erfolgsquote, die Online-Fehlerwiederholungsrate, die zeitnahe Veröffentlichung, die durchschnittliche Verzögerung und Modellkostenänderungen zu verwenden, um eine quantitative Akzeptanz durchzuführen, und dann zu entscheiden, ob auf weitere Geschäftsbereiche ausgeweitet werden soll.
Versionsinfo
- Testverbesserungen und Infrastrukturaktualisierungen :Das offizielle Update-Protokoll zeichnet Testergebnisse auf, zeigt die Erfolgsquote entsprechend der Konfiguration an, korrigiert den Aufruffokus des Playground-Tools, verarbeitet den o1-preview/o1-mini-Argumentationsaufwand und andere Verbesserungen.
- Langtail 1.0 :Der offizielle Blog veröffentlichte Langtail 1.0 und konzentrierte sich auf das Hinzufügen von tabellenähnlichen Testschnittstellen, Testkonfigurationen, gehosteten Code-Tools und Assistenten.
- Öffentliche Beta :Der offizielle Blog veröffentlicht die öffentliche Betaversion von Langtail, den öffentlichen kollaborativen Arbeitsbereich Playground, die schnelle Bereitstellung, Protokollanalyse, Tests und OpenAI/Azure OpenAI-Unterstützung.
Benutzerbewertungen