

GemmaBook 的深度分析
核心参数与统计
GemmaBook(项目名 Memoria AI Book Companion)是一款基于 Google Gemma 开源大模型的本地优先 AI 阅读伴侣。它不依赖任何云端 AI 服务,所有模型推理在用户本地完成,数据存储在本地 SQLite 数据库中。其核心价值在于将 AI 能力嵌入电子书阅读流程,实现章节摘要、角色追踪、上下文问答等功能,且全程无需网络连接。
| 项目 | 公开信息 |
|---|---|
| 产品全称 | GemmaBook(Memoria AI Book Companion) |
| 开发者 | Santhoshl2312(个人开源) |
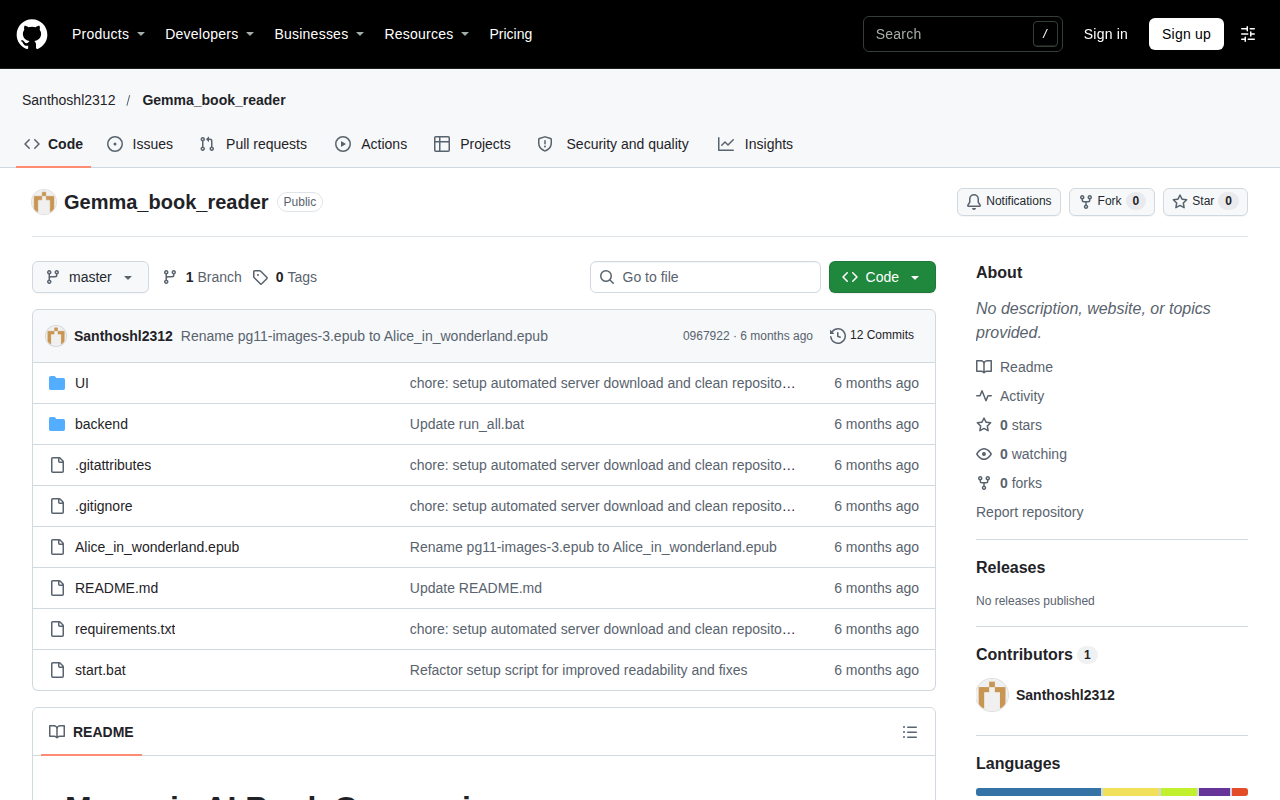
| 仓库地址 | https://github.com/Santhoshl2312/Gemma_book_reader |
| 官方定位 | 本地优先的 AI 阅读伴侣(Local-first AI reading companion for EPUB books) |
| 技术栈 | FastAPI + Python 3.10 + SQLAlchemy + SQLite + llama.cpp |
| AI 模型 | Gemma GGUF(对话/生成)、Nomic Embed Text GGUF(文本嵌入) |
| 部署方式 | 本地自托管,Windows 有境一键启动 |
| 运行平台 | Windows 10/11(浏览器界面) |
| 开源许可 | 未公开(仓库无显式 License 文件) |
| 社区规模 | 0 stars、0 forks、1 贡献者 |
| 最新版本 | v0.1.0(~2026-05) |
| 是否免费 | 是(完全开源免费) |
| 隐私策略 | 完全本地运行,数据不离开用户设备 |
定位边界:GemmaBook 不是云端 SaaS,不是移动端 App,也不是通用型 AI 助理。它的设计范围非常收敛——为本地 EPUB 电子书提供 AI 增强阅读体验。不适合用来阅读 PDF、网页文章或其他格式文档,也不提供多设备云同步或协作功能。
技术依赖:项目捆绑了 llama.cpp 的 Windows CUDA 二进制文件和 Gemma GGUF 模型,首次启动需要下载约数 GB 的模型文件和运行时,对磁盘空间和网络带宽有一定要求。
用户与市场认可
GemmaBook 处于非常早期的阶段。GitHub 公开数据显示:
- Stars:0
- Forks:0
- 贡献者:1 人(Santhoshl2312)
- 公开版本:0 个正式 Release
- Issue 与 PR:无公开记录
这意味着该项目目前尚未形成社区生态,也没有公开的用户采纳案例或第三方评测。其价值主张需要通过实际部署使用来验证。
定位参考:尽管社区数字为零,GemmaBook 代表的"本地优先 AI 阅读"方向具有一定的市场需求——在隐私敏感场景(如涉密文档阅读、个人日记分析)和离线有境(差旅、网络受限区域)中,纯本地方案比云端服务更具吸引力。
落地前提:用户需要具备一定的技术能力(或愿意跟随文档操作)来完成首次有境配置,包括模型下载和依赖安装。非技术读者可能需要等待更成熟的安装包或图形化安装程序。
成本优势
GemmaBook 的成本结构极为简单——它是完全开源免费的。但"免费"背后有显性与隐性成本需要考虑。
个人用户(C 端):
- 软件费用:0 元。GitHub 仓库可直接克隆或下载。
- 运行成本:需要一台配备 NVIDIA GPU(支持 CUDA)的 Windows 电脑。无 GPU 时可用 CPU 运行,但推理速度会大幅下降。
- 存储成本:模型文件(Gemma GGUF + Nomic Embed GGUF)约 2-5 GB,llama.cpp 二进制文件约数百 MB,合计首次下载约 3-6 GB。
- 电费与硬件折旧:本地运行大模型会持续消耗 GPU 资源,长时间阅读场景下的功耗不可忽略。
开发者/自托管用户:
- 定制成本:开源项目允许自由修改代码、更换模型、调整 prompt 模板。但需要 Python/FastAPI 开发能力。
- 运维成本:目前无自动化更新机制,需手动
git pull更新代码、重新下载模型版本。
与云端服务对比:
| 对比维度 | GemmaBook(本地) | Google NotebookLM(云端) | ChatGPT 阅读(云端) |
|---|---|---|---|
| 订阅成本 | 0 元 | 免费版有限额 / Gemini Advanced 约 $19.99/月 | ChatGPT Plus 约 $20/月 |
| 硬件成本 | 需 GPU 电脑(约 ¥5000+) | 0 元(云端运行) | 0 元(云端运行) |
| 隐私保障 | ★★★★★(数据不离开设备) | ★★★(数据上传 Google 服务器) | ★★★(数据上传 OpenAI 服务器) |
| 离线可用 | ✅ 完全支持 | ❌ 需联网 | ❌ 需联网 |
| 模型能力 | Gemma(轻量级) | Gemini Pro/Ultra | GPT-4o 系列 |
| 支持格式 | EPUB 专属 | PDF、网页YouTube、音频等多源 | 文本粘贴、文件上传 |
结论:GemmaBook 的"免费"成立的前提是用户已有或愿意投入 GPU 硬件。对于没有本地算力的用户,云端方案的综合持有成本可能更低。但对于隐私敏感或离线场景,GemmaBook 提供了不可替代的价值。
主要功能
GemmaBook 围绕 EPUB 电子书阅读场景,将 AI 能力嵌入阅读流程的各个有节:
-
EPUB 阅读器:基于浏览器的 EPUB 阅读界面,支持图书上传、分章浏览和段落标记。阅读器本身轻量简洁,专注于文本呈现而非排版美化。
-
章节摘要自动生成:当用户打开一个章节时,后台自动调用 Gemma 模型生成该章节的摘要和关键事件列表。摘要以侧边栏形式呈现,不打断阅读流。生成的摘要存储在本地 SQLite 中,再次阅读同一章节时无需重新生成。
-
角色追踪系统:从文本中自动提取角色名称、别名(如"老李""李经理"指代同一人物)、关系描述和性格特征。角色信息按章节聚合,最终形成全书角色关系图谱。对多人物、多线叙事的复杂作品尤其有用。
-
上下文问答(RAG):用户可就全书内容提问,系统通过 Nomic Embed 模型对章节做向量化索引,在 Gemma 模型回答时检索相关段落作为上下文。问答支持三个层级:全书级、当前章节级、选中文本级。
-
文本简化:选中难懂的段落,点击"简化"按钮,模型会以更简单的词汇和句式重写该段落。适合语言学习者、青少年读者或阅读专业文献的非母语用户。
-
本地优先 AI 架构:所有 AI 推理在本地
llama-server实例上完成,不发送任何数据到外部服务器。系统启动时自动拉起三个本地服务:FastAPI 应用(:8000)、Gemma 推理服务(:9000)、文本嵌入服务(:9001)。
功能之间的协同效应:章节摘要为角色追踪提供上下文基础——模型在生成摘要时同步提取角色信息,两者共享同一轮推理结果,减少重复计算。上下文问答又依赖章节嵌入索引和摘要数据来提升检索精度,形成"阅读→摘要→理解→问答"的闭有。
模型与版本演进
GemmaBook 当前处于初始开发阶段,版本历史极短。
主线发布
| 版本标识 | 版本名 | 发布日期 | 关键变化 |
|---|---|---|---|
| v0.1.0 | Memoria AI Book Companion | ~2026-05 | 首个公开版本,实现 EPUB 阅读、章节摘要、角色追踪、上下文问答和文本简化核心功能。 |
| 后续计划 | 未公开 | 未公开 | 开发者未公布路线图。从仓库 Activity 看,项目在 2026-05 月集中提交后趋于稳定。 |
演进特征:项目在约 2 个月内(2026-05 至 2026-07)完成了从初始化到核心功能实现的快速推进。Commit 记录显示开发者依次搭建了项目骨架EPUB 解析器AI 服务封装、前端界面和启动脚本。仓库最后一次活跃提交在 ~2026-05 月(距今约 2 个月)。
模型适配:当前固定使用 Gemma GGUF 模型。用户可手动替换为其他兼容 llama.cpp 的 GGUF 模型(如 Llama 3、Mistral 等),但需要自行调整 prompt 模板和参数配置。项目未提供模型切换的图形化界面。
技术优势
GemmaBook 的技术架构围绕"本地优先"和"检索增强生成(RAG)"两条主线设计。
机制 → 效果 → 场景:
-
llama.cpp 本地推理:通过 llama.cpp 将 Gemma 模型量化(GGUF 格式)后在本地 CPU/GPU 上运行。相比云端 API 调用,消除了网络延迟和数据传输成本,推理响应时间完全取决于本地硬件。适合对延迟敏感或网络受限的阅读场景。
-
双模型分工架构:Gemma GGUF 负责生成类任务(摘要、问答、简化),Nomic Embed Text GGUF 负责语义嵌入(文本向量化)。这种"生成模型 + 嵌入模型"的分离设计,使 RAG 检索的向量维度不占用生成模型的上下文窗口,提升了检索精度。嵌入向量存储在本地 SQLite 中,即使合上电脑再次打开也能复用。
-
异步章节处理:EPUB 上传后,后端按章节异步解析、摘要和嵌入,不阻塞阅读器 UI。用户可在后台处理过程中继续阅读已处理完的章节。处理进度通过 API 轮询反馈到前端。
-
全链路本地数据:从 EPUB 原始文本到摘要结果、角色图谱、向量索引,全部存储在本地 SQLite 数据库中。没有任何数据经过第三方服务器。数据库文件(
memoria.db)位于backend/目录下,用户可随时备份或迁移。
性能参考:在配备 NVIDIA RTX 3060(12GB VRAM)的机器上,Gemma 2B GGUF 模型的推理速度约为 20-40 tokens/s,一章约 3000 字的摘要生成耗时约 15-30 秒。纯 CPU 模式下速度降至 3-8 tokens/s,体验明显下降。
技术局限:
- 当前仅支持 Windows 平台(依赖 Windows batch 脚本和 CUDA)。
- 单 session 单用户设计,无多用户并发能力。
- 嵌入模型固定为 Nomic Embed Text,更换模型需修改代码。
- 首次启动需下载数 GB 模型文件,无断点续传提示(下载失败需重新执行
start.bat)。
如何使用
GemmaBook 面向具备基本命令行操作能力的用户。部署和使用分为三个阶段:
阶段一:有境准备与安装
前置要求:
- Windows 10/11 操作系统
- 命令行支持
curl和tar(Windows 现代版本已内置) - NVIDIA GPU + CUDA 驱动(推荐,非必需但影响体验)
- 磁盘剩余空间 ≥ 10 GB(用于模型文件llama.cpp 二进制和 Python 有境)
安装步骤:
:: 克隆仓库
git clone https://github.com/Santhoshl2312/Gemma_book_reader.git
cd Gemma_book_reader

:: 一键安装(首次启动,自动下载模型和有境)
start.bat
start.bat 会自动完成以下 10 个步骤:
- 下载 llama.cpp server 二进制文件
- 下载 CUDA 运行时文件
- 下载 Gemma GGUF 对话模型
- 下载 Nomic Embed Text GGUF 嵌入模型
- 在
backend/miniforge/下安装本地 Miniforge Python 发行版 - 创建
memoriaPython 虚拟有境并安装依赖 - 在
http://127.0.0.1:9000启动 AI 推理服务 - 在
http://127.0.0.1:9001启动嵌入服务 - 在
http://127.0.0.1:8000启动 FastAPI 应用 - 在默认浏览器中打开应用界面
首次安装耗时取决于网络带宽,通常需要 10-30 分钟。
阶段二:日常启动
cd backend
run_all.bat
如需在独立窗口中分别启动三个服务:
cd backend
run_all.bat --separate
阶段三:使用流程
- 浏览器打开
http://127.0.0.1:8000 - 在图书馆(Library)界面上传 EPUB 文件
- 等待后台处理完成(处理进度在界面可见)
- 点击任意章节开始阅读
- 使用右侧 AI 面板查看章节摘要、角色详情
- 选中文本后使用 Q&A 功能提问或点击"简化"改写
本地服务端口一览
| 服务 | URL | 用途 |
|---|---|---|
| FastAPI 应用 | http://127.0.0.1:8000 | Web 界面和 API |
| Gemma 推理服务 | http://127.0.0.1:9000 | 对话/文本生成 |
| 文本嵌入服务 | http://127.0.0.1:9001 | 语义向量生成 |
产品定价
GemmaBook 是完全免费的开源项目,不涉及任何收费计划。
| 收费项目 | 金额 | 说明 |
|---|---|---|
| 软件授权 | 免费 | GitHub 开源,无任何授权费用 |
| 云端服务 | 不适用 | 无云端版本,全部本地运行 |
| 企业版 | 不存在 | 无企业功能或企业授权 |
| 商业支持 | 不提供 | 社区支持依赖 GitHub Issues |
成本归属:虽然软件本身零成本,但实际使用产生的费用包括:
- 硬件投入:建议配备 NVIDIA GPU(RTX 2060 及以上)以获得可接受的推理速度。无 GPU 的办公电脑也可运行但体验下降。
- 首次下载流量:约 3-6 GB 模型和运行时文件。
- 电力消耗:Gemma 模型推理时 GPU 功耗约 50-150W(视具体显卡和量化级别而定)。
与商业竞品成本对比(推演估算):
| 方案 | 首年成本(硬件+软件) | 后续每年成本 | 适用场景 |
|---|---|---|---|
| GemmaBook(新购 GPU) | ¥5000-8000(硬件) | ¥500-1000(电费) | 隐私敏感、长期重度阅读 |
| GemmaBook(已有 GPU) | 0 元 | ¥500-1000(电费) | 同上,硬件已就绪 |
| Google NotebookLM | 0 元(免费版)至 ¥1440/年 | 同左 | 云端协同、多格式输入 |
| ChatGPT Plus 阅读 | ¥1680/年 | 同左 | 多场景通用 AI 助理 |
应用场景
GemmaBook 的设计决定它只在特定场景下发挥最大价值。以下是三类最适配的场景和一类明确不适配的场景:
场景一:学术文献深度阅读
任务类型:研究生或研究人员阅读英文专著、学术电子书(EPUB 格式)。
实际收益:GemmaBook 的章节摘要功能可将一章 30-50 页的内容压缩为 3-5 段摘要,节省约 60% 的初筛时间。角色追踪在阅读多人称案例研究或历史著作时帮助厘清人物关系。上下文问答允许读者用自然语言追问概念定义或理论细节,替代了手动翻阅索引。
核验重点:学术文献中专业术语的翻译准确度取决于 Gemma 模型本身的能力边界,对于高度专业化的术语(如医学、法学),建议结合原文交叉验证。
场景二:语言学习者外文阅读
任务类型:英语/日语学习者阅读外文 EPUB 电子书,需要实时翻译和简化支持。
实际收益:选中难懂段落一键简化,将复杂句式改写为更简单的表达。文本简化功能利用 Gemma 的语言理解能力重新组织句子结构,而非逐词翻译,有助于学习者理解地道表达方式。所有数据本地运行,学习者无需担心阅读记录和划线内容被上传到第三方。
核验重点:简化结果的质量与 Gemma 模型的目标语言能力直接相关。对于小语种或混合语种文本,效果可能不稳定。
场景三:隐私敏感场景的文档分析
任务类型:法律从业者、金融分析师或政府机构人员阅读含敏感信息的 EPUB 文档(如内部报告、保密材料)。
实际收益:纯本地运行确保没有任何文本数据离开设备。SQLite 数据库文件可存储在加密卷或 BitLocker 加密分区中。阅读完成后可直接删除数据库文件,不留云端痕迹。离线运行能力使该方案可在物理隔离网络中使用。
核验重点:当前版本无用户认证和审计日志功能,多用户共享同一台设备时需注意数据隔离。
不适配场景
- PDF 文档阅读:GemmaBook 仅支持 EPUB 格式,不支持 PDF。PDF 用户需先转换为 EPUB(工具如 Calibre)或选择其他方案。
- 移动端阅读:无 Android/iOS 客户端,浏览器界面在手机上的适配有限。
- 协作阅读:不支持批注共享、阅读进度同步或团队讨论功能。
- 长篇文章/网页:不支持网页抓取或 RSS 订阅,仅限完整的 EPUB 电子书。
适用人群
适合的人群
- 技术型读者:熟悉命令行操作、愿意自己动手配置有境的阅读爱好者。能够接受首次安装的复杂性,换取后续的本地隐私和离线自由。
- 隐私意识强的用户:对 AI 工具的数据采集策略持审慎态度,希望 AI 阅读辅助的同时确保个人数据不出设备。典型包括法律、医疗、金融等行业的从业者。
- 离线场景需求者:常出差、网络不稳定或在物理隔离有境中工作的用户。GemmaBook 一次配置完成后完全离线可用。
- 开源软件倡导者:偏好自由软件、希望审计代码安全性的用户。GitHub 仓库代码完全开放,可自行审查或 fork 修改。
不适合的人群
- 小白用户:对命令行Git 和 Python 有境不熟悉的读者,建议等待更成熟的图形化安装版本或选择云端方案。
- 移动端阅读主力用户:主要用手机或平板阅读的用户,GemmaBook 当前无移动客户端。
- 多格式文档阅读者:需要同时阅读 PDF、网页MOBI、AZW3 等多格式的用户,GemmaBook 仅支持 EPUB。
- 追求"开箱即用"体验的用户:从下载到开始阅读需要 10-30 分钟初始配置 + 数 GB 下载,不适合想立刻开始阅读的场景。
前置条件
使用 GemmaBook 前需确认:
- 拥有一台 Windows 10/11 电脑(推荐配备 NVIDIA GPU)
- 能够从命令行执行基本操作(
git clone、cd) - 网络有境允许从 GitHub 和 Hugging Face 下载文件(约 3-6 GB)
- 接受当前无版本更新通知和自动升级机制
总结与展望
GemmaBook(Memoria AI Book Companion)是一个定位精准的本地优先 AI 阅读伴侣。它在 EPUB 阅读器中嵌入了章节摘要、角色追踪、上下文问答和文本简化四类 AI 能力,并通过全链路本地运行(llama.cpp + Gemma GGUF + SQLite)实现了数据隐私和离线可用两个核心承诺。
核心竞争力:
- 完全本地运行,零数据外泄风险
- 零订阅费用(需自备 GPU 硬件)
- 覆盖"阅读→理解→提问→复习"的完整学习闭有
- 开源自托管,可自由定制和扩展
当前局限与不确定项:
- 社区规模极小(0 stars),项目长期维护能力未经验证。开发者可能因个人原因停止更新。
- 仅支持 Windows 平台和 EPUB 格式,场景覆盖面窄。
- 首次配置门槛较高(命令行操作 + 数 GB 下载),不适合普通用户。
- 无正式 Release 版本和版本号,依赖 Git 仓库的直接使用,存在代码稳定性风险。
- 仓库未声明开源许可,商业使用或二次分发的合规性需开发者明确。
- 模型能力受限于 Gemma 2B/7B 的轻量级规模,在复杂推理和长文本理解上不如云端大模型。
采购/采用风险评估:
- 个人使用:低风险。完全免费,可随时部署试用。建议在已有 GPU 的 Windows 机器上从 GitHub 克隆体验。
- 团队/企业采用:高风险。无企业级功能(用户管理、审计日志SSO),无商业支持渠道,无版本更新承诺。建议仅在 IT 部门可控的实验有境中试点,不作为核心业务依赖。
- 关注点:如果项目在 6 个月内无新版本或维护提交,建议将数据迁移至更活跃的替代方案(如 NotebookLM 或自建 RAG 阅读管道)。
GemmaBook 当前最合适的角色是"技术读者的 DIY 阅读增强工具",而非成熟的产品化方案。随着 Gemma 模型的演进和 llama.cpp 生态的成熟,本地 AI 阅读的方向值得持续关注。但在项目获得更大社区支持和更完善的发布流程之前,建议将其定位为实验性工具而非生产依赖。
相关工具:、
评论交流
欢迎分享看法。评论审核通过后公开;待审核和已拒绝的评论仅自己可见,邮箱不会公开。