

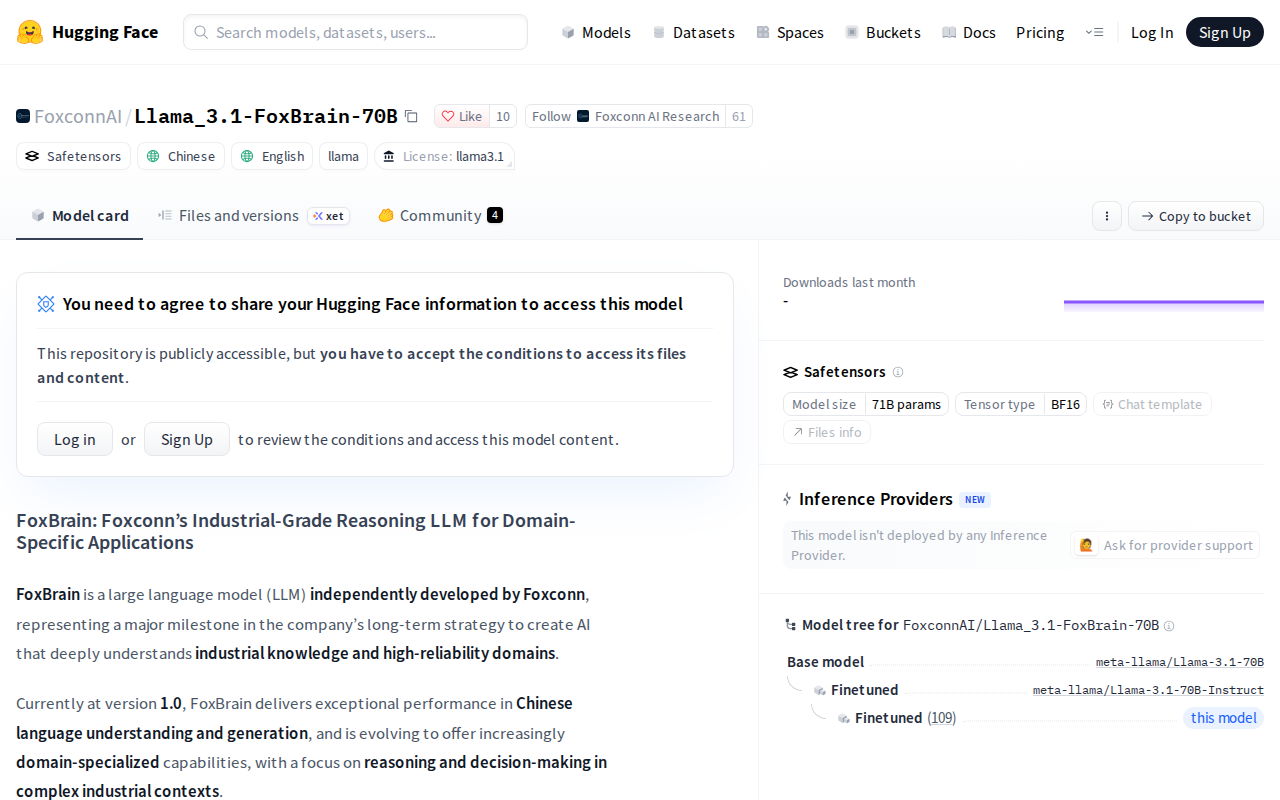
FoxBrain — 鸿海研究院工业级推理大语言模型
核心参数与统计
FoxBrain 是鸿海研究院(Hon Hai Research Institute,富士康旗下)推出的首款繁体中文工业级推理大语言模型(LLM),基于 Meta Llama 3.1-70B 架构,使用 120 张 NVIDIA H100 GPU 在四周内完成训练。其核心能力涵盖数据分析、数学推理、代码生成、文本摘要与问答对话,面向智能制造、供应链管理和智慧决策等工业场景。
| 参数项 | 数值 |
|---|---|
| 基础架构 | Meta Llama 3.1-70B |
| 参数量 | 70B |
| 上下文窗口 | 128K tokens |
| 训练硬件 | 120 × NVIDIA H100 GPU |
| 训练耗时 | 约 4 周(2,688 GPU days) |
| 训练数据 | 98B tokens 高质量中文预训练数据 |
| 支持语言 | 繁体中文(为主)、英文 |
| 许可证 | Llama 3.1 Community License |
FoxBrain 采用高效训练策略,专注于训练过程优化而非盲目堆砌算力。通过自主开发的 24 类主题数据增强方式与品质评估方法,生成了 98B tokens 的高质量中文预训练资料,并使用 Adaptive Reasoning Reflection 技术训练模型学会自主推理。在 TMMLU+ 测试中,FoxBrain 在大多数领域优于同规模的 Llama-3-Taiwan-70B,尤其在数学与逻辑推理方面表现卓越。
用户与市场认可
FoxBrain 作为台湾地区首款具备推理能力的繁体中文大语言模型,自 2025 年 3 月由鸿海研究院发布以来,受到产业界与学术界的广泛关注。模型在 TMMLU+ 学术基准测试中表现优异,在数学与逻辑推理领域超越同规模的 Meta Llama 3.1-70B 和 Llama-3-Taiwan-70B,显示其强大的理解与推理能力。
2025 年 7 月,FoxBrain 正式在 Hugging Face 平台开源(需申请授权),并整合进 NVIDIA NIM 微服务架构,方便开发者基于模型构建客制化应用。在 2026 年 NVIDIA GTC 大会上,FoxBrain 展示了在智慧电动车领域的应用,并与 SAP 宣布战略合作,加速亚太地区企业 AI 落地。产品仍处于早期成长阶段,尚未公开具体的用户量和企业客户数据。
成本优势
| 对比维度 | FoxBrain (LLM) | 商用闭源大模型(如 GPT-4) | 自训练开源模型 |
|---|---|---|---|
| 模型架构 | Meta Llama 3.1-70B | 闭源专有架构 | 需自行选型 |
| 训练成本 | 受限开源,2,688 GPU days | 对外不可知 | 取决于算力投入 |
| 推理部署 | 2–8 张 H100 GPU | API 按量计费 | 自行运维 |
| 中文优化 | 专为繁体中文优化 | 通用多语言 | 需自行微调 |
| 许可证 | Llama 3.1 Community(免费开源) | 按 Token 付费 | 取决于基座模型 |
FoxBrain 采用开源策略,基于 Llama 3.1 Community License 发布,企业和开发者可以免费获取模型权重并进行部署和二次开发。相比商用闭源大模型按 Token 计费的持续成本,FoxBrain 的一次性部署模式在长期大规模使用场景下具有显著成本优势。同时,模型专门针对繁体中文和工业场景进行了优化,在特定领域任务上可达到接近世界领先水平的性能。
主要功能
- 多步推理(Chain-of-Thought):采用 Adaptive Reasoning Reflection 技术,模型能够进行多步推理和逻辑推断,在数学题、逻辑谜题和复杂决策任务中表现出色。支持逐步思考过程的可视化输出。
- 数据分析与理解:能够处理结构化数据(表格CSV)和非结构化文本,执行数据分类、趋势识别、异常检测等分析任务。适用于财务报告分析、运营数据解读等场景。
- 代码生成与解释:支持多种编程语言的代码生成、代码审查和自然语言解释。可辅助开发人员进行功能实现Bug 定位和代码优化。
- 繁体中文优化:在高质量台湾繁体中文数据集上进行了微调,对台湾用语习惯、文化背景有更好的理解,生成的文本更贴合本地语境。
- 长上下文处理:支持 128K token 的上下文窗口,可一次性处理长文档、多轮对话或大规模代码库,满足工业场景的复杂需求。
- VLLM 快速部署:支持通过 VLLM 推理框架进行高效部署,2–8 张 H100 GPU 即可运行,具备超低延迟推理能力。
模型与版本演进
| 版本 | 发布日期 | 主要变化 |
|---|---|---|
| 0.9(内部训练版本) | 2025-03 | 基于 Meta Llama 3.1-70B,使用 120 张 H100 在 4 周内完成训练 |
| 1.0 Preview(当前版本) | 2025-07 | 在 Hugging Face 开源,整合 NVIDIA NIM,支持 VLLM 部署 |
0.9 版本验证了高效训练策略的可行性——仅用 2,688 GPU days 即完成了 70B 参数模型的训练,远低于同类模型。1.0 预览版本则在模型权重基础上进一步优化了推理能力,并提供了完整的 VLLM 部署方案和 API 接入指南。后续 Roadmap 包括:2.x 版本逐步增强工业知识、领域特定推理和智能制造专长,长期目标是构建真正理解制造业、自动化和智慧城市生态的 AI 基础模型。
技术优势
FoxBrain 的技术优势体现在其高效训练策略和针对工业场景的专项优化上:
- 高效训练策略:使用 120 张 NVIDIA H100 GPU 通过 NVIDIA Quantum-2 InfiniBand 网络进行多节点并行训练,仅耗时约 4 周(2,688 GPU days)。相比同类 70B 模型动辄上万 GPU days 的消耗,FoxBrain 在算力效率上具有显著优势。通过自主技术建立的 24 类主题数据增强方法,生成了 98B tokens 的高质量中文预训练数据。
- Adaptive Reasoning Reflection:独特的推理反射技术,训练模型学会自主推理而非简单模式匹配。该技术在数学和逻辑推理测试中显著提升了模型表现,使其在 TMMLU+ 上超越同规模基线模型。
- 工业场景适配:模型专为繁体中文和工业领域优化,在制造业知识、供应链管理、智慧决策等场景的语义理解上优于通用模型。128K token 的上下文窗口使其能够处理完整的工业文档和技术规范。
- NVIDIA NIM 集成:整合进 NVIDIA NIM 微服务架构,开发者可以基于标准 API 快速构建客制化应用,无需管理底层推理基础设施。
这种专注工业领域的高效训练路径使得 FoxBrain 在特定场景下以更低的算力成本获得了接近世界领先水平的性能表现。
如何使用
| 入口方式 | 地址 | 使用说明 |
|---|---|---|
| Hugging Face 模型页 | https://huggingface.co/FoxconnAI/Llama_3.1-FoxBrain-70B | 申请授权后下载模型权重进行部署 |
| GitHub 仓库 | https://github.com/Foxconn-Research/FoxBrain | 获取部署脚本与文档 |
| 鸿海研究院公告 | https://www.honhai.com/zh-tw/press-center/press-releases/latest-news/1548 | 官方发布信息 |
典型使用步骤(基于 VLLM 部署):
- 前往 Hugging Face 模型页申请授权(需登录并同意许可协议)。
- 安装 VLLM 推理框架(
pip install vllm==0.8.4)。 - 使用 VLLM 启动推理 API 服务,配置模型路径GPU 数量和上下文长度。
- 通过标准的 OpenAI 兼容 API 调用模型,进行文本生成、问答、代码辅助等任务。
- 也可将模型集成到企业应用中,通过 NVIDIA NIM 微服务架构进行部署。
- 查阅 GitHub 仓库中的文档和 Google Colab 示例笔记本快速上手。
注意:模型需要 2–8 张 H100 GPU 运行,建议使用支持 CUDA 的有境。
产品定价
FoxBrain 基于 Llama 3.1 Community License 以开源形式发布,模型权重免费获取(需在 Hugging Face 申请授权)。企业和开发者无需支付许可费用即可下载模型并进行部署和二次开发。
使用成本主要体现在基础设施方面:运行 FoxBrain 需要 2–8 张 NVIDIA H100 GPU,根据云服务商定价,GPU 租赁成本约为每小时数十至上百美元。对于需要 API 调用的场景,可通过自行部署 VLLM 服务以 Token 用量计费,成本远低于同等能力的商用闭源模型。
应用场景
- 智能制造优化:FoxBrain 可应用于生产计划排程、质量缺陷分析、设备预测性维护等场景。通过理解制造领域的专业术语和工艺流程,辅助工程师快速定位生产异常。
- 供应链智能管理:利用模型的推理能力分析供应链数据,识别潜在风险点,优化库存管理和物流调度。与 SAP 等企业系统的集成进一步放大了这一价值。
- 企业知识问答:基于 128K 上下文窗口,可处理长篇幅的工业文档、技术规范和操作手册,构建企业内部的智能知识库问答系统。
- 代码辅助与自动化:辅助开发团队进行代码生成、审查和重构,特别是在制造业相关的自动化脚本和数据分析 Pipeline 构建中提升效率。
适用人群
- AI 研究团队:希望基于开源模型进行二次微调或研究推理能力提升的研究者。FoxBrain 的高效训练策略和完整的训练方法文档具有很高的参考价值。
- 制造业企业:需要部署私有化大语言模型来处理制造数据、优化生产流程的工业企业。FoxBrain 在工业场景的专项优化使其成为比通用模型更合适的选择。
- 系统集成商与 ISV:为企业客户构建 AI 解决方案的开发者,可通过 FoxBrain 的 NVIDIA NIM 集成快速部署客制化应用。
- 学术机构:需要繁体中文大语言模型进行教学或研究的学者和学生。FoxBrain 的开源发布降低了研究门槛。
需要注意的是,FoxBrain 目前仍处于预览阶段,部分功能尚在完善中。模型主要面向繁体中文和工业场景优化,在通用英文任务和其他领域的表现可能不如同等规模的通用模型。部署需要一定的 GPU 基础设施,不适合个人用户直接使用。
总结与展望
FoxBrain 作为台湾地区首款具备推理能力的繁体中文工业级大语言模型,其核心价值在于以极低的算力成本(2,688 GPU days)训练出了在数学与推理领域接近世界领先水平的 70B 参数模型。通过开源策略和 NVIDIA NIM 集成,降低了企业和开发者使用工业级 AI 模型的门槛。当前局限包括:仍处于预览阶段,部分功能尚在完善;模型主要针对繁体中文和工业场景优化,通用领域的覆盖度不如同等规模的通用模型;访问权限需要申请审核,尚未完全开放。
后续值得关注的方向包括:2.x 版本逐步增强的工业知识和领域特定推理能力、与 SAP 等企业系统的深度集成、以及面向智慧制造、智慧城市等场景的专有模型变体。随着 FoxBrain 从预览走向正式发布,其在全球制造业 AI 应用中的影响力有望进一步扩大。
相关工具:
评论交流
欢迎分享看法。评论审核通过后公开;待审核和已拒绝的评论仅自己可见,邮箱不会公开。