
FutureX 的深度评测:LLM 智能体的未来预测能力试金石
核心参数与统计
| 项目 | 详细信息 |
|---|---|
| 产品名称 | FutureX |
| 产品类型 | LLM 智能体评估基准 (Research Benchmark) |
| 交付形态 | arXiv 论文 + 自动化评估管道 |
| 支持语言 | 英文 |
| 目标用户 | AI 研究员LLM 开发者、智能体平台 |
| 数据来源 | 195 个高质量网站 |
| 问题领域 | 政治、经济、金融、体育、娱乐 |
| 问题类型 | 单选、多选、开放排名、数值预测 |
| 难度层级 | 4 级 (Level 1-4) |
| 评估频率 | 每日自动更新 |
| 输出规模 | 每周约 500 个事件 |
FutureX 并非传统意义上的商业 SaaS 工具,而是一个面向 LLM 智能体(Agent)的动态实时评估基准。其核心贡献在于解决了 LLM 评估中长期存在的"数据污染"问题——通过专注于尚未发生的未来事件,确保模型在预测时答案尚未公开,从而获得公正、无污染的评估结果。
用户与市场认可
作为学术研究项目,FutureX 获得了来自多家顶级机构研究团队的认可:
- 联合发布方:字节跳动、复旦大学、斯坦福大学、普林斯顿大学四家机构的研究人员共同参与。
- 模型覆盖:在论文中对 25 个 LLM/Agent 模型进行了系统评估,包括 Grok-4、Gemini-2.5-flash Deep Research、GPT 系列DouBao-Seed1.6-Thinking 等主流模型。
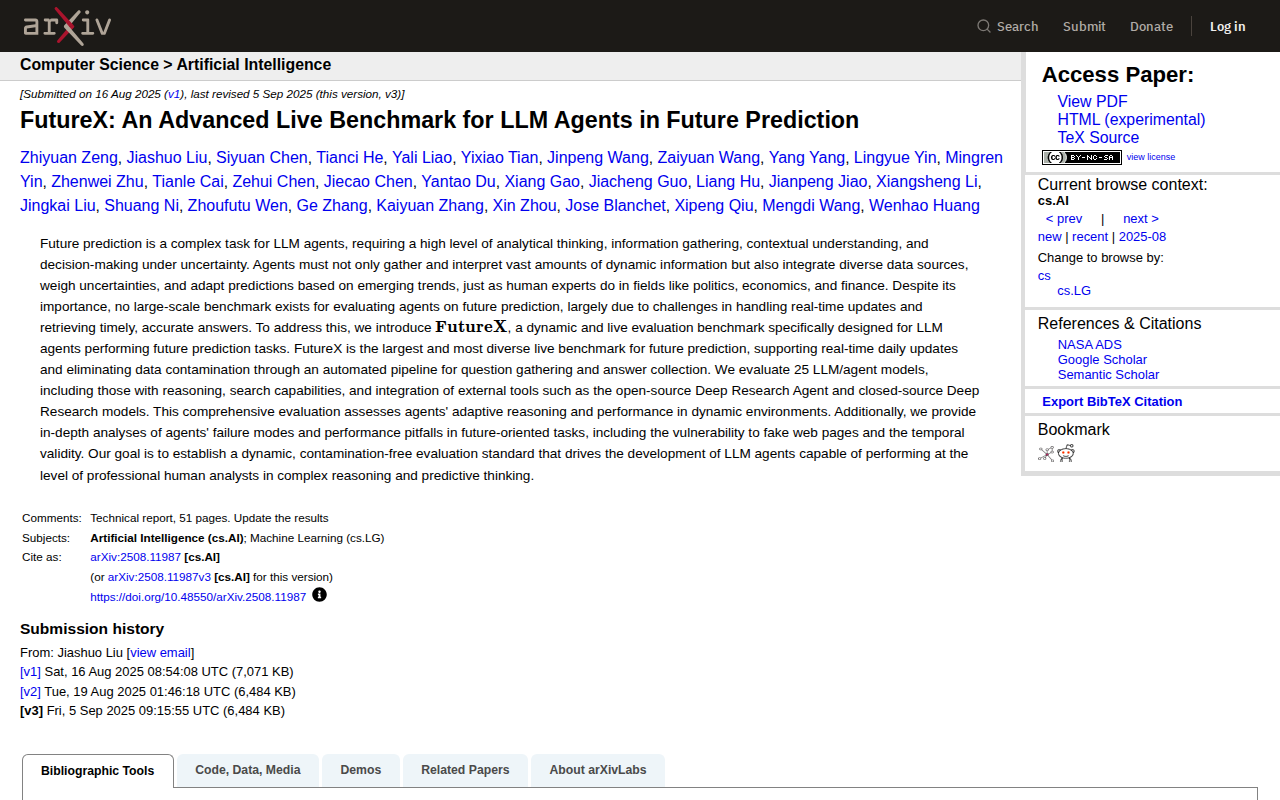
- arXiv 收录:论文发布于 arXiv(2508.11987),截至 2025 年 9 月已更新至 v3 版本。
与传统静态基准(如 MMLU、GSM8K)不同,FutureX 的动态特性使其能够持续跟踪模型能力的演进,而不必担心测试集泄露带来的"应试教育"效应。
成本优势
| 成本维度 | 说明 |
|---|---|
| C 端 / 研究者 | 完全免费。论文、评估数据、构建方法论均开源获取。 |
| API / 开发者 | 无需 API 费用。基准本身不收取使用费,研究者可参考其方法论自行搭建评估管道。 |
| 企业 / 私有化 | 企业可参照 FutureX 的方法论构建内部评估体系,无需支付许可费。 |
- 隐性成本:部署和运行完整的 FutureX 评估管道需要一定的工程投入——包括配置 195 个数据源的爬取、事件模板生成、模型预测调度等。对缺乏基础设施的团队而言,这部分人力成本不可忽略。
- 隐性收益:避免数据污染的评估结果可以显著降低模型选型决策的试错成本,尤其适合对实时预测能力有高要求的金融、政治分析等领域。
主要功能
- 动态实时评估:通过半自动化管道从 195 个高质量网站实时收集未来事件问题,在事件解决后自动获取真实结果进行评分。与每年更新一次的静态基准不同,FutureX 的问题集每天都在动态更新。
- 无数据污染保证:由于评估问题全部基于尚未发生的事件,模型无法通过记忆训练数据来"作弊"。这从根本上解决了 LLM 评估中最棘手的 test-set contamination 问题。
- 多类型任务支持:涵盖单选、多选、开放性排名和数值预测四种问题类型,全面评估模型在不同预测任务上的表现。从"某股票下周涨跌"到"某国大选结果概率",覆盖多种预测场景。
- 四层难度分级:从 Level 1(简单事实类选择题)到 Level 4(超级代理层级——需要深度研究、多源信息综合的开放问题),系统评估模型的渐进式推理能力。
- 大规模跨领域覆盖:从 195 个高质量网站收集问题,覆盖政治、经济、金融、体育和娱乐等多个领域,每周生成约 500 个事件,是目前最大和最多样化的实时未来预测基准。
模型与版本演进
FutureX 以 arXiv 论文形式发布,目前有三个版本:
- v1 (2025-08-16):初始版本,定义了 FutureX 基准的整体架构和评估方法论,对 25 个 LLM/Agent 模型进行了初步评估。
- v2 (2025-08-19):对评估流程和数据呈现进行了优化,修正了部分实验数据。
- v3 (2025-09-05):最新版本,更新了更多模型(包括 Grok-4、Deep Research 等)的评估结果,对失败模式和性能瓶颈进行了更深入的分析。
三个版本的核心架构保持一致,主要差异在于模型覆盖面和实验深度的逐步扩展。官方未提供独立于论文之外的版本管理页面,后续更新以 arXiv 页面为准。
技术优势
架构链路:FutureX 的核心评估流程如下:
LLM Agent → 事件获取 → 信息收集(搜索/浏览)→ 预测输出 → 等待事件解决 → 真实结果比对 → 评分
                ↑                                                              |
                └──────── 每日自动化管道:195 网站爬取 + 模板生成 ──────────────┘
- 自动化管道:使用 AIME 代理自动收集大量相关网站 URL,通过 LLM + 人工审核筛选出 195 个高质量站点,生成事件模板,实现每日自动策划与评估。
- 抗污染设计:传统基准的最大问题是模型可能在训练数据中见过测试题目。FutureX 通过专注于未来事件,从根本上规避了这一缺陷——模型无法预知尚未发生的事情。
- 真实世界挑战模拟:FutureX 不仅评估模型的记忆能力,更测试其信息收集、数据合成、概率权衡和因果推理等高级认知技能,将模型置于真实世界的信息流中。
- 细粒度失败分析:提供了对模型失败模式的深入分析,包括对虚假网站的脆弱性、时间有效性判断能力等,为模型改进提供了明确的优化方向。
如何使用
FutureX 作为一个研究基准,使用方式与商业工具有所不同:
| 用途 | 说明 |
|---|---|
| 论文阅读 | 直接访问 arXiv 页面阅读完整技术报告 |
| 方法论参考 | 论文详细描述了评估管道的构建过程,可复现 |
| 模型自评 | 参考 FutureX 的问题收集与评估方法论,搭建自有评估体系 |
| 数据引用 | 论文数据可作为模型性能对比的参考依据 |
典型研究路径:阅读 arXiv 论文 → 理解评估方法论 → 参考管道设计搭建评估系统 → 接入自有模型进行评测 → 对比论文中的基线结果。
需要注意的是,FutureX 并非 SaaS 产品,不提供注册即用的在线评估平台。其价值主要体现在方法论参考和实验结果对比上。
产品定价
- C 端 / 研究者:完全免费。论文全文、评估数据均可通过 arXiv 开放获取。
- API / 开发者:无收费计划。研究团队未提供商业 API,全部内容以学术开放获取方式发布。
- 企业 / 私有化:企业可无偿使用 FutureX 的方法论构建内部评估体系。论文采用 CC BY-NC-SA 4.0 许可协议,非商业用途免费,商业用途需自行确认合规边界。
应用场景
- 模型选型与对比:在 Grok-4、Gemini-2.5-flash、GPT-4o、DouBao-Seed1.6 等模型之间进行公平的未来预测能力对比,为采购决策提供参考。
- 智能体能力评估:评估 Deep Research Agent 等工具增强型智能体在真实世界预测任务上的表现,而非仅关注传统 QA 或代码生成能力。
- 金融预测模型验证:评估模型对股票价格、经济指标等金融事件的预测能力,辅助金融机构筛选高性能分析代理。
- 模型迭代优化:通过细粒度的失败模式分析(虚假网站识别、时间有效性判断),为模型改进提供明确方向。
- 学术研究参考:作为 LLM 评估方法论的前沿探索,为后续研究提供基准设计和实施参考。
适用人群
- AI 研究员与学者:关注 LLM 评估方法论、数据污染问题、智能体能力边界的研究人员,可以将 FutureX 作为评估工具或对比基准。
- 模型开发者:正在训练或微调 LLM/Agent 模型的团队,可使用 FutureX 的方法论来检验模型在未来预测任务上的真实能力。
- 金融/政策分析机构:需要评估 AI 在真实预测任务上表现的专业机构,可参考 FutureX 的实验结论辅助决策。
- 不适合人群:
- 寻找即用型商业 AI 工具的终端用户(FutureX 是研究基准,非 SaaS 产品);
- 需要开箱即用评估平台的团队(当前无在线 Demo 或 UI 界面);
- 对实时新闻类预测无需求的场景(FutureX 专注于未来事件预测,不适合知识问答或代码生成等传统评测)。
总结与展望
FutureX 代表了 LLM 评估领域的一个重要方向——从静态、可能被污染的测试集转向动态、实时、无法被预知的评估范式。它通过精巧的管道设计解决了数据污染这一顽疾,为智能体的真实能力评估提供了更可靠的标尺。
不适配边界:FutureX 并非通用 LLM 基准,它专注于未来预测这一特定能力维度。对于代码生成、数学推理、长文本理解等其他能力维度,仍需结合传统基准综合评估。此外,当前 FutureX 仅支持英文问题,中文本地化尚未覆盖。
采购/采用风险评估:对于考虑采用 FutureX 方法论的企业,需注意以下风险:① 评估管道的运维成本——持续爬取 195 个数据源并保持模板更新需要稳定的工程投入;② 领域覆盖偏差——当前数据源以西方主流媒体和金融数据为主,对亚洲市场、小语种领域的覆盖有限;③ 学术许可限制——CC BY-NC-SA 4.0 许可证对商业用途有额外限制,企业需在上线前完成合规审查。建议先通过 arXiv 论文充分理解方法论与数据边界,再评估是否值得投入工程资源搭建内部评估体系。
相关工具:
评论交流
欢迎分享看法。评论审核通过后公开;待审核和已拒绝的评论仅自己可见,邮箱不会公开。