

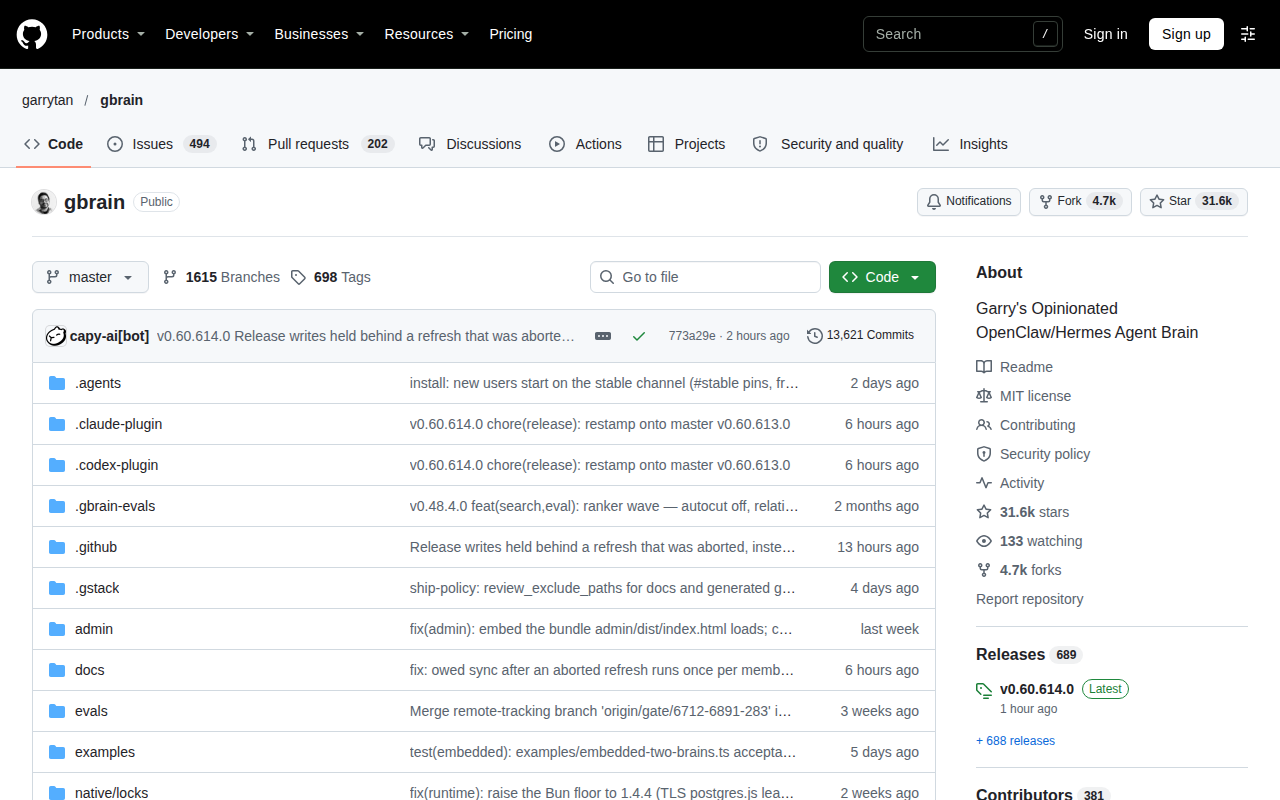
GBrain
核心参数与统计
| 项目 | 详细信息 |
|---|---|
| 产品名称 | GBrain |
| 产品类型 | AI Agent 长期记忆系统 |
| 交付形式 | CLI / MCP Server / Agent Skill |
| 开源协议 | MIT |
| 当前版本 | v0.42.62.0 |
| 仓库语言 | TypeScript (97.2%) |
| GitHub Stars | 26.6k |
| GitHub Forks | 3.8k |
| 贡献者 | 106 |
| 开发作者 | Garry Tan(Y Combinator 总裁兼 CEO) |
| 支持平台 | CLI(macOS/Linux/Windows)、MCP(stdio/HTTP)、Agent 集成 |
GBrain 不是传统意义上的 SaaS 工具,而是一个面向 AI Agent 的开源记忆层系统。它将散落的 Markdown 笔记转化为可按混合搜索、可推理图谱遍历、持续自动 enrich 的知识大脑,解决「Agent 做完任务就失忆」的核心矛盾。
用户与市场认可
GBrain 由 Y Combinator 总裁 Garry Tan 亲自开发并用于其个人生产有境(OpenClaw / Hermes Agent 部署),拥有 146,646 个页面24,585 个人物5,339 家公司66 个定时任务的实盘验证数据规模。截至 2026 年 7 月,GitHub 获 26.6k Stars、3.8k Forks,社区贡献者 106 人。
在 Agent 记忆系统领域,GBrain 是已知唯一通过 YC 总裁每日实战验证的生产级方案,其搜索精度(P@5 49.1%,R@5 97.9%)相比纯向量 RAG 提升 +31.4 个百分点,有公开的可复现评估基准仓库(gbrain-evals)。
成本优势
| 成本维度 | 说明 |
|---|---|
| 软件本身 | MIT 开源,完全免费,无商业使用限制 |
| 本地运行 | PGLite(嵌入式 Postgres WASM)零配置本地运行,零服务成本 |
| 嵌入模型 | 默认 ZeroEntropy 免费额度,可选 OpenAI / Voyage / Ollama 等 16 种嵌入提供商 |
| 云同步 | Supabase Postgres($25/月起步)用于多设备同步或团队部署 |
| API Key | 需自行配置 OpenAI(嵌入)、Anthropic(可选子 Agent)、Groq(语音转录)等 |
| 算力成本 | 确定性后台队列(Minions)零 Token 成本,判断性工作按需调用 LLM |
免费的真相:软件本身免费,但运行需要自有 API Key。默认嵌入使用 ZeroEntropy(含免费额度),大规模生产部署需要 Supabase 订阅或自托管 Postgres。与 SaaS 工具不同,GBrain 的成本结构是「开源软件免费 + 基础设施按需付费」。
主要功能
- 混合搜索:向量(pgvector HNSW)+ BM25 关键词 + 倒数排序融合(RRF)+ 来源层级加权 + 意图感知查询重写。三种搜索模式(conservative / balanced / tokenmax)一键切换成本/质量。Recall@5 达 95%。
- 知识图谱自连接:每次页面写入后,确定性正则管道自动提取实体引用(Markdown 链接 + bare slugs),推断类型化关系(attended / works_at / invested_in / founded / advises),零 LLM 调用完成去重、失效链接清理、反向链接更新。
- Compiled Truth + Timeline 双层知识模型:每个 Markdown 页面以
---分隔为上层 Compiled Truth(当前最佳理解,随新证据持续改写)与下层 Timeline(只追加不删除的原始证据链),让认知可进化同时保留完整审计轨迹。 - Minions 后台队列:Postgres 原生作业队列,将确定性工作与判断性工作分离。确定性任务平均 753ms 完成、零 Token 成本100% 成功率;判断性任务通过子 Agent 异步执行。
- 43 个内置 Skill:覆盖信号捕获、多源内容摄入(会议/邮件/推特/PDF/视频/GitHub)、实体自动丰富、每日简报、语音通话(Twilio + OpenAI Realtime)、知识一致性巡检、引用修复等。
- MCP Server 接入:通过
gbrain serve暴露 30+ MCP 工具,可接入 Claude Code / Cursor / Windsurf / Claude Desktop / Cowork / Perplexity / ChatGPT 等主流 MCP 客户端。
模型与版本演进
GBrain 采用 MAJOR.MINOR.PATCH.MICRO 四段式版本号,当前版本 v0.42.62.0。核心版本脉络:
| 版本 | 时间 | 变化要点 |
|---|---|---|
| v0.1.0 | ~2026-04 | 初始版本,Postgres 原生知识大脑基础架构 |
| v0.3.0 | ~2026-04 | 契约优先架构 + ClawHub 插件系统 |
| v0.10.3 | ~2026-05 | 知识图谱自连接功能上线 |
| v0.12.0 | ~2026-05 | 零 LLM 调用知识图谱自连接 + 混合搜索 |
| v0.35.1.0 | ~2026-05 | 评估基准基线版本 |
| v0.40.7.0 | ~2026-06 | Agent 自演进 Schema 能力 |
| v0.41.22 | ~2026-06 | gbrain-base-v2 15 类型规范分类法 |
| v0.42.62.0 | ~2026-07 | 同步过滤、依赖安全修复、搜索优化 |
详细版本日志见仓库 CHANGELOG.md。
技术优势
三层分离架构:GBrain 采用 Brain Repo(Git 托管的 Markdown 文件,人类可读可编辑的唯一数据源)→ GBrain 检索层(Postgres + pgvector 混合搜索引擎)→ AI Agent(43 个 Skill 定义读写逻辑)的分离架构。Agent 通过 BrainEngine 接口读写,底层支持 PGLite(嵌入式 Postgres,零配置)和 PostgresEngine(Supabase)双向热迁移。
搜索为何更快更准:向量(HNSW on pgvector)+ BM25 关键词 + RRF 融合 + 来源层级加权 + 意图感知查询重写,叠加 ZeroEntropy reranker。每次搜索还可附加图谱信号——若某结果是该查询的「枢纽节点」则实施邻接提升,跨团队大脑结果实施交叉来源提升,同一会话中过多低质量块实施降权。gbrain search --explain 可查看每阶段分数明细。
确定性成本控制:通过 Minions 将确定性工作(正则提取、链接解析、去重)与 LLM 判断性工作分离。确定性任务使用 Postgres 原生队列,零 Token 成本且 100% 成功;仅 enrichment、synthesis 等需要推理的任务才调用 LLM,避免为结构化操作支付推理费用。
Compiled Truth + Timeline 认知进化:区别于纯覆盖式更新(丢失历史)或纯追加(查询噪音),双层模型保证既有最新的最佳理解,又有完整的可审计证据链。Agent 在回答时可同时引用结论和证据来源。
如何使用
| 入口 | 说明 |
|---|---|
| Agent 自动安装(推荐) | 在 OpenClaw / Hermes Agent 中粘贴安装指令,30 分钟完成全自动部署 |
| CLI 独立使用 | bun install -g github:garrytan/gbrain → gbrain init --pglite → gbrain import ~/notes/ → gbrain query "..." |
| MCP Server | 本地通过 gbrain serve 暴露 30+ MCP 工具,接入 Claude Code/Cursor/Windsurf;远程部署 Supabase 后通过 ngrok 接入 Claude Desktop |
| Claude Code / Codex 快速接入 | gbrain init --pglite + claude mcp add gbrain -- gbrain serve |
典型流程:
- 在 Agent 中粘贴安装指令或通过 CLI 安装 GBrain
gbrain init --pglite在 2 秒内初始化本地大脑gbrain import ~/notes/导入 Markdown 笔记- Agent 自动识别并加载 43 个 Skill,配置定时任务
- 使用
gbrain query "..."或通过 MCP 客户端查询
产品定价
| 层级 | 费用 | 说明 |
|---|---|---|
| 开源软件 | 免费 | MIT 协议,可商用、可修改、可再分发 |
| 本地运行 | 免费 | PGLite 零配置本地运行,无需服务器或 Docker |
| 嵌入模型 | 按 API Key 付费 | 默认 ZeroEntropy(有免费额度),可选 16 种嵌入提供商 |
| 云同步 | $25/月起 | Supabase Postgres 订阅,用于多设备同步或团队部署 |
| API Key 需求 | 自备 | 需 OpenAI(嵌入)、Anthropic(可选子 Agent)、Groq(语音转录)等 |
GBrain 是开源项目,无 SaaS 订阅费。生产部署的成本主要是嵌入 API 调用费和可选的云数据库托管费。与同功能商业产品(如需要 $20-50/月的个人知识库订阅 + API 调用费)相比,GBrain 在软件层面零成本,基础设施按实际用量付费。
应用场景
- 投资人/创始人关系管理:自动归档会议、邮件、社交动态,会前 30 秒生成对方完整档案与历史互动。Garry Tan 本人用于管理 YC 投资组合的 3000+ 人脉。
- 个人知识库:将多年笔记、文章、想法转化为可推理的知识图谱,支持「我半年前对某事的观点」类查询。管理 10000+ 文件规模。
- 研究自动化:摄入论文、报告、视频后自动提取实体、建立引用、生成时间线,辅助学术或行业研究。
- 内容创作辅助:追踪灵感来源、自动补全引用、维护主题标签一致性,防止创作过程中的信息遗漏。
- 团队共享记忆:支持 OAuth 作用域隔离的多用户部署,每位团队成员只能看到自己被授权的页面,零数据泄露。适用于 10-50 人团队的「公司大脑」场景。
- 智能日程与任务:每日自动准备会议简报、巡检过期页面、修复损坏引用、生成周期性报告。
适用人群
- AI Agent 使用者:已经运行 OpenClaw、Hermes、Claude Code、Codex 等 AI Agent,需要让 Agent 拥有长期记忆的用户。这是 GBrain 最核心的目标人群。
- 个人知识管理重度用户:拥有海量 Markdown 笔记(Obsidian 等),希望将其转化为可搜索、可推理的知识图谱,而非仅文件搜索的个人用户。
- VC/投资人:需要管理大量人脉、交易、会议记录,且希望 Agent 能自动帮做会前准备和投后跟踪的投资机构。
- 开发者与开源爱好者:对自托管、自部署、开源方案有偏好的技术用户,愿意自行配置 API Key 和基础设施。
不适配人群:
- 不想自己管理 API Key 或基础设施的用户——这不是开箱即用的 SaaS,需要自行配置 LLM API 和数据库。
- 只需要简单笔记搜索的用户——GBrain 的学习曲线和部署复杂度对于仅有基本笔记查询需求的用户来说过度了。
- 对数据隐私有极端要求但又不想自托管的用户——虽然支持本地运行(PGLite),但多设备同步需要云数据库。
- 非英语内容为主且需要深度中文分词的场景——GBrain 的 FTS 默认使用英语词干分析器,中文支持需要额外配置(如 jieba 分词扩展)。
总结与展望
GBrain 的核心竞争力在于它不是又一个笔记应用或向量数据库,而是一个真正为 AI Agent 设计的记忆层:混合搜索 + 知识图谱自连接 + 确定性后台队列 + 43 个可扩展 Skill,让 Agent 从「每次对话从零开始」进化为「拥有不断增长的知识大脑」。其作者 Garry Tan 的 YC 总裁身份和 14 万页实盘验证赋予了产品极高的可信度。开源 MIT 协议也消除了商业采用的顾虑。
当前局限包括:CLI 为主的使用方式对非技术用户门槛较高;社区贡献的编排方式(PR 批处理而非实时合并)可能导致某些修复延迟落地;项目迭代速度极快(已到 v0.42+),部分功能稳定性仍处于快速演进期。
采购/采用风险评估:GBrain 作为开源项目没有商业 SLA 支持,关键生产部署需依赖社区或内部维护能力。API Key 费用随使用量线性增长,大规模部署前建议先用默认 ZeroEntropy 免费额度验证效果。项目目前单点风险较高——核心维护者仅 Garry Tan 一人(虽有 106 名贡献者但多为社区 PR),建议 fork 备份关键版本,并关注项目治理结构的变化。
相关工具:
评论交流
欢迎分享看法。评论审核通过后公开;待审核和已拒绝的评论仅自己可见,邮箱不会公开。