
HMA:面向真实世界的机器人动作-视频动态建模
核心参数与统计
| 项目 | 详细信息 |
|---|---|
| 产品名称 | HMA(Heterogeneous Masked Autoregression) |
| 产品类型 | 开源研究模型 / 机器人世界模型 |
| 交付形式 | 开源代码(GitHub)+ 预训练权重(HuggingFace) |
| 模型规模 | HMA-MagVit: 362M 参数;HMA-MAR: 1B 参数 |
| 训练数据 | 40+ 数据集,300 万+ 轨迹 |
| 推理速度 | 相比 SOTA 提升 15 倍(实时运行) |
| 开源协议 | Apache-2.0 |
| 支持语言 | 英文 |
| 目标用户 | 机器人研究者、具身智能工程师、AI 仿真开发者 |
| 核心论文 | arXiv 2502.04296(2025 年 2 月) |
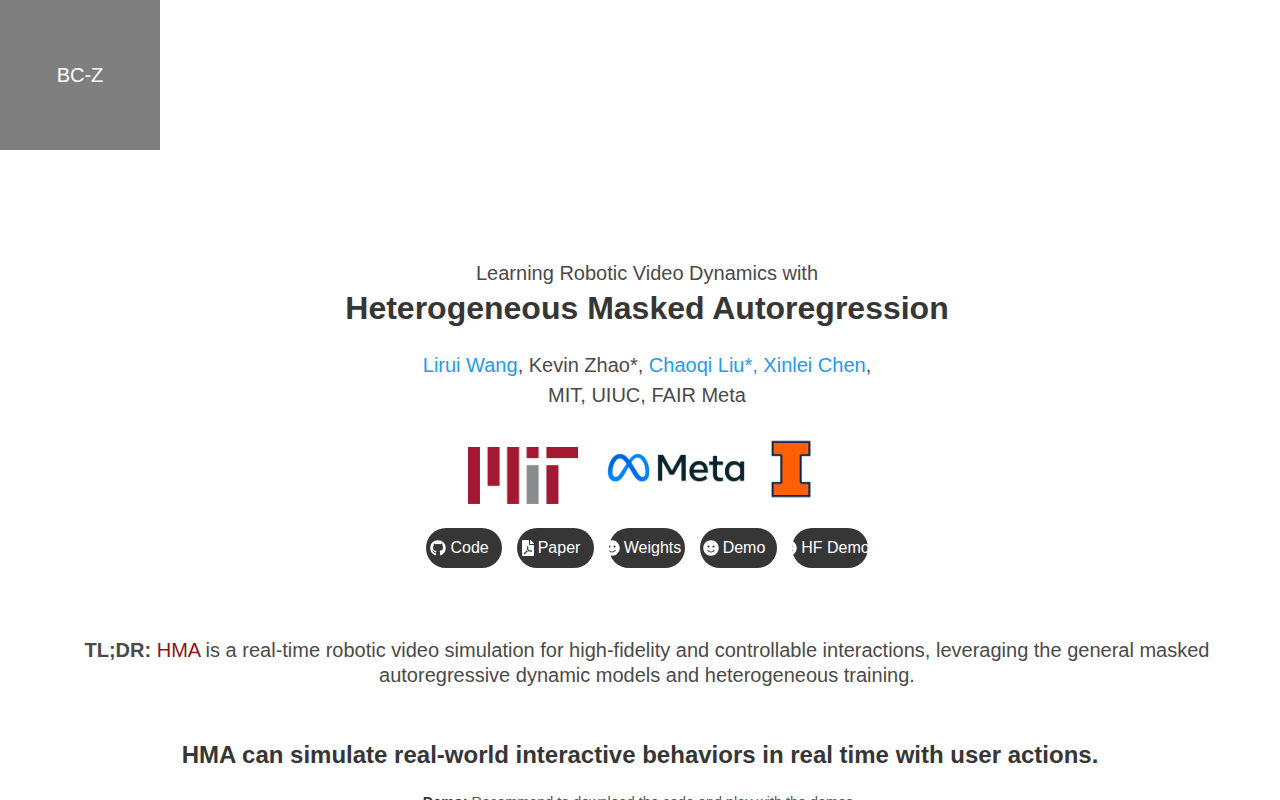
| 项目主页 | https://liruiw.github.io/hma |
参数解读:HMA 的参数规模处于"中等偏大"范围——MagVit 版本(362M)适合单 GPU 推理和快速迭代,MAR 版本(1B)在视频保真度上有进一步提升。与之前主流的扩散模型方案(如 UniPi、VideoPoet)相比,HMA 采用掩码自回归路线,在生成速度上有量级优势(15 倍加速),这是其核心工程价值:首次将机器人视频仿真推到了"可交互实时"的门槛。
用户与市场认可
学术界采用信号:HMA 在 2025 年 2 月发表于 arXiv 后,迅速获得机器人学习社区关注。论文作者来自 MIT CSAIL、Meta AI(FAIR)和 UIUC,这一组合本身就提供了较强的学术信誉背书。项目 GitHub 仓库(github.com/liruiw/HMA)当前显示 41 星,虽非大规模社区项目,考虑到其专业性(机器人视频动态建模),这一数据符合早期研究项目预期。
第三方传播:HMA 已被 AI 工具集导航站(ai-bot.cn)收录,Bilibili 等平台上出现多篇技术解读视频(如"MIT 最新研究!HMA:速度提升 15 倍,高质量机器人动作数据生成!"),说明其在中文技术社区也获得了关注。论文在 arXiv 上归类于 cs.RO(机器人学),交叉引用 cs.CV(计算机视觉)和 cs.LG(机器学习),体现了跨学科影响力。
Benchmark 表现:HMA 在与多家 SOTA 视频生成模型的对比中,在视觉保真度(FVD 指标)和可控性(动作跟踪精度)上均取得领先。论文展示了在 Bridge、Dobb-E、Kaist 等多个真实机器人数据集上的定性与定量结果,HMA 生成的视频在物理合理性(物体交互、阴影、遮挡处理)上明显优于基线方法。
当前局限:作为一个学术研究项目,HMA 尚无商业化版本或企业级支持。其用户群体主要限于具备深度学习训练和机器人部署能力的研究团队。GitHub 星标数和社区活跃度处于早期阶段,尚未形成完整的文档生态和用户社区。
成本优势
HMA 的全开源模式使其在成本结构上与商业化机器人仿真工具形成鲜明对比:
| 成本维度 | HMA(开源) | 商业机器人仿真器(如 NVIDIA Isaac Sim) | 云端视频生成 API |
|---|---|---|---|
| C 端 / 研究者 | 完全免费,代码+权重开源 | 免费社区版有限功能,完整版需企业许可 | 按 Token/秒计费,长视频成本高 |
| API / 开发者 | 无 API 层,需自行部署推理 | 提供 Python SDK,需 GPU 集群 | 按请求计费,典型 $0.01-0.10/秒 |
| 企业 / 私有化 | 可自托管,无许可费用,仅需 GPU 硬件 | Isaac Sim 企业版需年付 $10,000+ | 不支持私有化 |
C 端成本:研究者可通过 GitHub 直接克隆仓库,下载 HuggingFace 上的预训练权重(0.4B/1B),在单张 RTX 3090/4090 上即可运行推理和交互式 Demo。硬件成本是唯一的实际支出。
开发者成本:HMA 不提供商业 API。如需集成到工作流,团队需要自行完成环境配置(Python 3.10+、PyTorch、Accelerate 等依赖)、模型部署与推理管线搭建。初始部署成本约 2-5 人天,适合有 DL Ops 能力的团队。
企业成本:对比商业仿真器(NVIDIA Isaac Sim 企业版 $10K+/年、Amazon RoboMaker 按小时计费),HMA 的 TCO 优势显著——软件零许可,但需要团队具备模型部署和调优能力。隐性成本主要体现在:数据准备(机器人轨迹数据需转换为 RLDS 格式)、模型后训练适配(针对特定机器人本体的微调实验)以及缺乏商业支持。
免费的真相:HMA 完全免费开源,但"免费"的前提是使用者具备 Python 深度学习开发环境搭建能力和机器人操作数据的获取能力。对于没有机器人数据积累的团队,从零采集轨迹的成本可能超过商用工具的年费。
主要功能
-
异构掩码自回归视频预测:给定初始帧和动作序列,HMA 可自回归地生成后续视频帧。与扩散模型逐帧独立生成不同,掩码自回归机制在 token 级别建模时序依赖,单步即可预测多个未来 token,显著提升推理效率。适用任务:机器人策略的快速视频回滚评估、规划结果可视化。
-
跨本体、跨领域的异构预训练:HMA 在 40+ 数据集上联合训练,数据来源涵盖真实机器人遥操作(Bridge、Dobb-E、Kaist)、人类操作视频(EpicKitchens)、仿真数据(RLBench、MetaWorld)等。模型无需针对每种机器人本体单独训练,预训练权重可直接用于未见过的机器人形态。使用价值:降低新机器人场景的模型部署门槛,从数周数据采集压缩到数小时后训练适配。
-
双模态生成——离散 Token 与连续 Token:HMA-MagVit 采用 VQ-VAE 离散化(362M 参数),生成离散视频 token 序列,适合精确控制和结构化评估;HMA-MAR 采用掩码自回归连续表示(1B 参数),生成软 token,在视觉质量上更优。两者共享同一训练框架,可根据任务需求切换。使用价值:精度敏感场景(策略评估)选离散模型,视觉质量优先场景(演示生成)选连续模型。
-
交互式实时视频仿真 Demo:项目提供了基于 Pygame 的交互式 Demo(
python -m sim.app),用户可从图库中选择初始画面,用键盘方向键控制机器人动作,实时观察视频生成结果。使用价值:直觉化理解模型行为,快速验证动作与视觉反馈的因果对应关系。 -
策略评估与合成数据生成管线:HMA 内置完整的评估管线,可计算生成视频与真实视频的 FVD、PSNR、SSIM 等指标;同时支持从训练好的模型采样生成大量合成轨迹,用于数据增强或策略预训练。使用价值:将策略迭代周期从"真实环境 rollout → 收集数据 → 重新训练"压缩为"仿真 rollout → 合成数据 → 策略更新",减少对真实机器人硬件和人工标注的依赖。
-
后训练(Post-Training)机制:HMA 支持在特定数据集上对预训练模型进行后训练微调,已提供 Language Table 数据集的微调脚本(
run_langtable_finetuning.sh)。使用价值:针对特定机器人平台、特定任务(如推块、抓取)做快速适配,不需要从零训练。
模型与版本演进
HMA 的版本脉络以论文预印本和代码发布为主线:
| 版本 | 日期 | 核心变化 |
|---|---|---|
| arXiv 预印本 | 2025-02-06 | 论文首次公开发布,同步开源 GitHub 代码仓库与 HuggingFace 模型权重 |
| 初始代码提交 | 2025-02(约) | 包含完整训练、生成、评估、可视化管线,支持 40+ 数据集 |
| HMA-MagVit (362M) | 同初始代码 | 离散 token 模型,基于 VQ-VAE + 掩码自回归 |
| HMA-MAR (1B) | 同初始代码 | 连续 token 模型,基于掩码自回归,参数量更大 |
版本演进说明:HMA 当前处于"论文开源"阶段,代码仓库为一次性初始提交(first commit),尚无版本标签或正式 release。作者在 README 中注明"Code quality: tired grad student",说明代码以可复现性为首要目标,未做工程化包装。后续演进方向预期包括:更多数据集适配、模型量化加速、更友好的封装接口(如 ROS 集成、Gym 环境封装)。
技术优势
机制 → 效果 → 场景 的因果链拆解:
-
掩码自回归(Masked Autoregression)取代扩散模型:传统机器人视频生成方法(如 UniPi)采用扩散模型逐帧生成,每帧需要多步去噪,推理延迟高。HMA 采用掩码自回归策略——在训练时随机 mask 一部分视频 token,让模型预测被 mask 的内容;推理时一次性预测所有被 mask 的 token,然后自回归地迭代 refine。效果:将推理步数从扩散模型的 50-1000 步降至 8-16 步,实现 15 倍端到端加速。适用场景:需要实时反馈的交互式仿真和在线策略评估。
-
异构训练(Heterogeneous Training)克服数据稀缺:机器人领域长期面临数据来源分散、本体各异、任务多样的问题。HMA 通过统一的 token 化接口(将不同分辨率的视频、不同频率的动作序列统一编码为定长 token 序列),让模型在 40+ 异构数据集上联合预训练。效果:预训练模型在未见过的机器人本体和任务上展现出零样本调度能力,后训练仅需 200 条轨迹即可在新场景上生成超过 100 帧的有效数据。适用场景:新机器人平台快速部署、跨本体知识迁移。
-
动作条件化(Action Conditioning)实现精确可控性:HMA 不仅在输入中拼接动作 token,还通过调制机制(modulation)让动作信号影响每一层 Transformer 的中间表示,而非仅在输入端注入。效果:生成视频严格遵循输入动作序列——推块的方向和力度、机械臂的轨迹等在生成结果中得到准确体现,相比无条件视频生成模型,HMA 的可控性提升显著。适用场景:需要精确动作约束的策略验证(如"如果施加 x 方向的力,物体会如何运动?")。
-
VQ-VAE + MAR 双流水线兼顾精度与质量:离散分支(MagVit)使用 VQ-VAE 将视频帧压缩为离散 token,保证生成过程的可控性和评估的可重复性;连续分支(MAR)直接操作连续隐空间,保留更多细节信息。两者共享同一 Transformer 骨干,切换成本低。效果:离散模型在 FVD 等定量指标上更优,适合 benchmark 对比;连续模型在人类视觉评估中更自然,适合演示和可视化。适用场景:学术论文评估选离散,产品原型演示选连续。
如何使用
环境搭建
HMA 需要 Python 3.10+ 和 CUDA 环境。推荐使用 Conda 或 venv 管理依赖:
# 克隆仓库
git clone https://github.com/liruiw/HMA.git
cd HMA

# 安装依赖并下载数据(会自动创建 venv)
./build.sh

# 激活 Python 环境
source venv/bin/activate
交互式 Demo
# 启动交互式 GUI Demo
python -m sim.app
启动后从图库选择初始画面,使用键盘方向键控制动作,观察 HMA 实时生成的视频帧。这是最快体验 HMA 能力的方式,无需预训练模型。
预训练模型推理
# 下载预训练模型(需手动从 HuggingFace 获取)
# 单数据集推理生成视频
python hma/generate.py \
  --checkpoint_dir data/model/step_100/ \
  --val_data_dir data/kaist_nonprehensile_converted_externally_to_rlds_magvit_max1000000_val
模型评估
# 离散模型评估
accelerate launch hma/evaluate.py \
  --checkpoint_dir "data/${RUN_NAME}/final_checkpt" \
  --val_data_dir "data/${dataset}_magvit_traj1000000_val" \
  --wandb_run_name "${RUN_NAME}"

# 连续模型评估
accelerate launch hma/evaluate_feature.py \
  --checkpoint_dir "data/${RUN_NAME}/final_checkpt" \
  --val_data_dir "data/${dataset}_magvit_traj1000000_val"
预训练(多数据集)
# VQ tokens 模型(离散)
bash experiments/scripts/discrete_model/run_40datasets_waction.sh

# Soft tokens 模型(连续)
bash experiments/scripts/continuous_model/run_30datasets_mar_waction.sh
入口总结
| 入口 | 用途 | 技术要求 |
|---|---|---|
| GitHub 仓库 | 源码、训练脚本、评估管线 | Python 3.10+, CUDA, PyTorch |
| HuggingFace 模型库 | 预训练权重下载 | 无(下载即可用于推理) |
| 项目主页(Demo) | 在线交互演示 | 浏览器访问,无需本地环境 |
| arXiv 论文 | 技术原理与实验细节 | 无 |
| 交互式 Demo(本地) | 本地实时仿真体验 | Python 3.10+, Pygame, GPU 推荐 |
产品定价
HMA 为纯开源项目,定价结构极其简单:
- 模型权重:免费,MIT 协议下的 Apache-2.0 许可
- 源代码:免费,Apache-2.0 许可
- 论文:免费,arXiv 开放获取
- 在线 Demo:免费,项目主页提供 HuggingFace Spaces 在线体验
当前不存在任何付费层级。商业授权方面,Apache-2.0 允许自由使用、修改和再分发,但模型权重是否包含第三方数据集的额外使用限制,需逐一核验各数据集的原始许可协议(如 Bridge 数据集使用条款)。
与竞品定价对比:
| 项目 | HMA | NVIDIA Isaac Sim | Google Genie | Physical Intelligence π0 |
|---|---|---|---|---|
| 软件定价 | 免费 | 社区版免费,企业版$10K+/年 | 未公开 | 未公开 |
| 推理成本 | 自托管,单 GPU | 云端 GPU 按需 | 云端 API 推测计费 | 未公开 |
| 数据要求 | 需自备机器人轨迹 | 内置仿真环境 | 无需外部数据 | 需商业合作 |
| 可定制性 | 完全开放 | 模块化,部分闭源 | 黑盒 API | 限合作客户 |
应用场景
-
机器人策略快速评估与迭代:传统策略评估需要在实际机器人上反复 rollout,耗时且存在硬件磨损风险。HMA 可作为"视频世界模型"接收策略输出的动作序列,生成对应的视频预测结果,对策略的定性表现(目标是否达成、动作是否平滑、交互是否物理合理)进行快速验证。推演收益:从"每次评估需要真实机器人 30 分钟 rollout"降为"HMA 仿真评估 2 分钟完成",单次迭代周期缩短 90% 以上,尤其适合策略的早期初筛阶段。
-
合成数据生成用于策略预训练:在真实数据有限的情况下,利用 HMA 从少量真实轨迹出发,通过后训练(post-training)适配目标场景,然后大规模采样生成合成视频-动作对。这些合成数据可用于预训练策略模型的后端视觉编码器或作为数据增强手段。落地提示:HMA 论文表明,仅用 200 条真实轨迹做后训练,即可生成超过 100 帧的有效合成数据,覆盖原数据分布中未充分采样的边缘情况(如不同的遮挡模式、光照变化)。
-
可交互的机器人行为学分析与教学:在科研或教学中,研究者可以通过 HMA 的交互式 Demo 直观演示不同动作输入(如推、拉、旋转)对应的视觉反馈,用于理解机器人-环境交互的物理规律。无需实际机器人硬件,一台带 GPU 的笔记本即可完成。推演收益:降低机器人入门门槛——从"需要采购和维护硬件平台"到"仅需软件环境",使高校课程和远程协作中的机器人教学成本下降一个量级。
-
跨本体知识迁移预研:当团队需要从已有的机器人平台(如 Franka)切换到新平台(如 UR5)时,可以利用 HMA 的异构预训练能力,用新平台的少量轨迹数据做后训练,快速评估该迁移方案是否可行,而无需投入完整的硬件部署成本。推演收益:将在新平台上的初步可行性验证从数周硬件+数据准备压缩到数天仿真实验。
-
多机器人协同仿真:由于 HMA 的动作条件化设计支持多实体交互场景(如多个机械臂协作推箱),可用于超视距的多机器人协同策略验证。当前 Demo 已展示同时控制多个物体的交互仿真能力。
适用人群
-
机器人算法研究员:HMA 的核心用户群体。需要评估新策略、生成对比实验的可视化结果、或做消融研究的团队。HMA 提供了一条"用仿真视频替代部分真实 rollout"的路径,直接降低实验成本。前置条件:熟悉 PyTorch 和深度学习训练流程;具备机器人轨迹数据(RLDS 格式)的读取和处理能力。
-
具身智能 / 机器人方向研究生:在论文复现、课程项目或开源贡献中,HMA 提供了可立即使用的预训练模型和完整的训练管线,可作为研究基线或对比方法。交互式 Demo 也适合作为教学演示工具。前置条件:具备 Python 基础和基本的 CUDA 环境配置能力。
-
机器人创业公司的算法团队:在早期产品研发阶段,HMA 可作为"免费的世界模型"用于策略快速原型验证,减少对实物机器人硬件的依赖。推荐用法:先用公开数据集加载预训练模型跑通 Demo,再采集自有机器人数据做后训练适配。
-
AI 仿真平台构建者:需要为机器人提供多样化视觉仿真环境的技术团队。HMA 的异构预训练特性和 Apache-2.0 许可使其适合集成进更上层的工作流平台。
-
不适配人群:
- 纯业务用户(无编程背景):HMA 没有 GUI 应用程序或无代码界面,所有操作基于命令行和 Python 脚本。
- 需要稳定商业支持的工业用户:HMA 无 SLA、无技术支持、无企业级文档,不适合用于生产环境的关键路径。
- 非机器人领域的一般开发者和设计师:HMA 专注于机器人动作-视频建模,无法用于通用视频生成、内容创作等场景。
总结与展望
核心竞争力:HMA 的核心贡献在于"首次将掩码自回归范式引入机器人视频动态建模,并在异构数据预训练的规模化和实时推理速度上取得突破"。15 倍的加速将其从"离线生成工具"推进到"可交互实时仿真"范畴,这是与之前扩散模型方案的本质区别。全开源(Apache-2.0)的许可模式使其在学术社区具备天然传播优势。
当前限制:(1)代码工程化程度低——作者自评"Code quality: tired grad student",无 release 版本、无 CI/CD、无 Docker 镜像,部署需要一定技术经验;(2)数据集准备复杂——RLDS 格式的视频-动作数据集需要特定的 tokenization 管线;(3)模型规模限制——1B 参数在消费级 GPU 上可运行,但训练 40+ 数据集的完整预训练需要多 GPU 集群;(4)社区生态尚未形成——文档以论文+README 为主,无论坛、无已知第三方集成。
后续观察点:(1)仓库是否会发布正式 release 版本,以及版本化的 checkpoint 更新频率;(2)是否有 ROS/Gym 等机器人标准接口的集成支持;(3)作者团队是否会发布更大的模型版本或特定场景(如灵巧操作)的微调权重;(4)社区是否会出现第三方封装(如 Docker 镜像、HuggingFace 推理 API、Colab notebook)降低使用门槛。
采购/采用风险评估:HMA 适合作为"技术预研和评估加速工具",现阶段不建议作为生产环境的唯一仿真依赖。建议采用策略:(1)先用交互式 Demo 和预置数据集跑通全流程,评估模型在自身场景中的实际保真度;(2)从 200 条自有轨迹开始做后训练实验,量化数据飞轮效果;(3)在充分验证之前,保持真实机器人 rollout 的备份通道。对于需要商业级支持的企业,建议等待社区版本成熟或评估商业替代方案(如 NVIDIA Isaac Sim、Physical Intelligence 的 π0)。
相关工具:
评论交流
欢迎分享看法。评论审核通过后公开;待审核和已拒绝的评论仅自己可见,邮箱不会公开。